OpenStack เป็นแพลตฟอร์มการประมวลผลแบบคลาวด์แบบโอเพ่นซอร์สที่มีสถาปัตยกรรมรวมบริการด้านการประมวลผล การจัดเก็บข้อมูล และเครือข่าย ซึ่งให้ความสามารถในการทำเสมือนจริงและฟังก์ชันการจัดการโดยอัตโนมัติที่ทรงพลัง เพื่อให้มั่นใจได้ถึงความพร้อมใช้งานสูงของแพลตฟอร์ม OpenStack จำเป็นต้องนำแนวทางการออกแบบสถาปัตยกรรมและมาตรการทางเทคนิคมารองรับบทความนี้จะแนะนำโซลูชันสถาปัตยกรรมความพร้อมใช้งานสูงของ OpenStack ที่นิยมใช้กัน
ความสามารถในการใช้งานสูงของ OpenStack
เพื่อเข้าใจวิธีการบรรลุความสามารถในการใช้งานสูง สิ่งสำคัญคือต้องระบุให้ชัดเจนว่าบริการใดมีแนวโน้มจะหยุดทำงานได้ ก่อนอื่นมาทำความเข้าใจพื้นฐานเกี่ยวกับโครงสร้างของ OpenStack กันก่อน
OpenStack ประกอบด้วยองค์ประกอบหลักห้าประการ ได้แก่ การประมวลผล(Nova) การจัดการตัวตน (Keystone) การจัดการภาพ (Glance) การจัดการด้านหน้า (Dashboard) และที่เก็บข้อมูลแบบออบเจกต์ (Swift)
โนวาเป็นองค์ประกอบหลักที่ทำหน้าที่ในการประมวลผลและการควบคุม ซึ่งรวมถึงบริการต่างๆ เช่น nova-compute, nova-scheduler, nova-volume, nova-network และ nova-api เช่นเดียวกับระบบที่กระจายศูนย์ส่วนใหญ่ OpenStack จะแบ่งออกเป็นสองประเภทของโหนด ได้แก่ โหนดควบคุมและโหนดประมวลผล โหนดควบคุมให้บริการทั้งหมดยกเว้น nova-compute ส่วนประกอบและบริการเหล่านี้สามารถติดตั้งแยกจากกันได้ และสามารถเลือกผสมผสานตามความต้องการ
Nova-compute ทำงานบนโหนดการประมวลผลแต่ละตัว สำหรับตอนนี้ สมมุติว่ามันเชื่อถือได้ มิฉะนั้นแล้ว อาจใช้เครื่องสำรองเพื่อเปลี่ยนการทำงานเมื่อเกิดข้อผิดพลาด (แม้ว่าการตั้งค่าเครื่องสำรองสำหรับโหนดการประมวลผลแต่ละตัวอาจมีค่าใช้จ่ายสูงเกินกว่าประโยชน์ที่ได้รับ)
ความสามารถในการใช้งานสูงของโหนดควบคุม
การรับประกันความพร้อมในการใช้งานของโหนดควบคุมถือเป็นความท้าทายหลัก โดยแต่ละส่วนประกอบต่างมีข้อกำหนดและวิธีการแก้ไขเฉพาะด้านด้านความพร้อมในการใช้งานของตนเอง
(1) หากโหนดควบคุมล้มเหลวจะเกิดอะไรขึ้น โดยพิจารณาจากมีเพียงโหนดควบคุมเดียวที่จัดการและควบคุมระบบทั้งหมด?
นี่คือปัญหาจุดล้มเหลวเดี่ยวที่พบได้บ่อย (SPoF) ความพร้อมใช้งานสูงไม่สามารถทำได้ด้วยเครื่องเพียงเครื่องเดียว โดยทั่วไปมักออกแบบโซลูชันเพื่อให้มั่นใจว่าสามารถเข้าควบคุมเครื่องที่ล้มเหลวได้อย่างรวดเร็วเมื่อเกิดปัญหาขึ้น แม้ว่านั่นจะมาพร้อมกับต้นทุนที่สูงขึ้นก็ตาม
เพื่อแก้ปัญหาจุดเดียวที่เกิดข้อผิดพลาด วิธีการทั่วไปคือการใช้อุปกรณ์สำรองหรือระบบสำรองร้อน เนื่องจากความล้มเหลวของฮาร์ดแวร์หรือข้อผิดพลาดของมนุษย์สามารถทำให้โหนดหนึ่งหรือหลายโหนดหยุดทำงานได้ และบางครั้งการบำรุงรักษาหรือการอัปเกรดต้องการให้หยุดการทำงานของโหนดบางตัวชั่วคราว ระบบเชื่อถือได้จะต้องสามารถทนต่อการหยุดทำงานของโหนดหนึ่งหรือหลายโหนดได้
โหมดการติดตั้งที่ใช้กันทั่วไป ได้แก่ โหมดสแตนด์บายแบบแอคทีฟ-แพสซีฟ โหมดแอคทีฟ-แอคทีฟ และโหมดคลัสเตอร์
(2) การสร้างโหนดควบคุมแบบซ้ำซ้อนทำได้อย่างไร? หรือมีวิธีอื่นใดบ้างที่สามารถทำให้การควบคุมมีความน่าเชื่อถือสูง?
หลายคนอาจพิจารณาใช้โหมดแอคทีฟ-พาสซีฟ โดยใช้กลไกหัวใจเต้น (heartbeat) หรือวิธีการอื่นที่คล้ายกันเพื่อสำรองข้อมูล และบรรลุความพร้อมใช้งานสูงผ่านการสลับระบบอัตโนมัติ OpenStack ไม่ได้รองรับโหนดควบคุมหลายตัวในตัวเอง ดังนั้น Pacemaker จึงจำเป็นต้องให้บริการต่างๆ ดำเนินการกลไกสำรอง ตรวจสอบ และสลับระบบด้วยตนเอง
เมื่อพิจารณาอย่างใกล้ชิดเกี่ยวกับบริการที่ให้โดยโหนดควบคุมจะเห็นได้ว่าประกอบด้วยหลักๆ ได้แก่ nova-api, nova-network, nova-scheduler, nova-volume รวมถึง Glance, Keystone และฐานข้อมูล MySQL ซึ่งบริการเหล่านี้ให้บริการแยกจากกัน Nova-api, nova-network และ Glance สามารถทำงานบนโหนดประมวลผลแต่ละตัวได้ RabbitMQ สามารถทำงานในโหมดหลัก-สำรองได้ และ MySQL สามารถใช้คลัสเตอร์ความพร้อมใช้งานสูงแบบซ้ำซ้อนได้
ส่วนต่อไปนี้จะอธิบายรายละเอียดขององค์ประกอบเหล่านี้
โซลูชันความพร้อมใช้งานสูงสำหรับส่วนประกอบหลัก
1) ความพร้อมใช้งานสูงของ nova-api และ nova-scheduler
โหนดคอมพิวต์แต่ละตัวสามารถรัน nova-api และ nova-scheduler ของตัวเองได้ เพื่อให้มั่นใจถึงการกระจายภาระงานสำหรับการทำงานที่เหมาะสม ด้วยวิธีนี้ เมื่อโหนดควบคุมล้มเหลว บริการ nova-api และบริการที่เกี่ยวข้องบนโหนดคอมพิวต์จะยังคงทำงานได้ตามปกติ
2) ความสามารถในการใช้งานสูงของ nova-volume
ปัจจุบันยังไม่มีโซลูชัน HA ที่สมบูรณ์แบบสำหรับ nova-volume และยังจำเป็นต้องทำงานเพิ่มเติม อย่างไรก็ตาม เนื่องจาก nova-volume ขับเคลื่อนโดย iSCSI การรวมเข้ากับ DRBD หรือใช้โซลูชันฮาร์ดแวร์ความพร้อมใช้งานสูงที่อิงจาก iSCSI สามารถทำให้เกิดความพร้อมใช้งานสูงได้
3) การมีเครือข่ายบริการที่พร้อมใช้งานสูง (nova-network)
OpenStack มีการให้บริการโซลูชันเครือข่ายสำหรับความพร้อมใช้งานสูงหลายรูปแบบอยู่แล้ว วิธีที่นิยมใช้กันทั่วไปคือ การเปิดใช้งานโหมดความพร้อมใช้งานสูงโดยใช้ตัวเลือก "Multi-host" โซลูชันอื่นๆ ที่พบได้บ่อย ได้แก่ Failover, Multi-nic, Hardware Gateway และ Quantum
4) การใช้งาน Glance และ Keystone ได้สูง
ภาพของ OpenStack สามารถจัดเก็บโดยใช้ Swift ได้ และ Glance สามารถรันบนโฮสต์หลายเครื่องได้ Pacemaker เป็นโซลูชันที่มีประสิทธิภาพสูงสำหรับการจัดการคลัสเตอร์หลายโหนด โดยใช้ในการสลับบริการและการเปลี่ยนไปใช้ระบบสำรองได้ และสามารถใช้งานร่วมกับ Corosync และ Heartbeat ได้ Pacemaker สนับสนุนโหมดต่าง ๆ ได้อย่างยืดหยุ่น เช่น แบบแอคทีฟ-พาสซีฟ N+1 และ N-N โดยการติดตั้ง OCF agent บนแต่ละโหนด จะสามารถตรวจสอบได้ว่าโหนดอื่นทำงานให้บริการ Glance และ Keystone อย่างถูกต้องหรือไม่ ซึ่งจะช่วยให้ Pacemaker เริ่มต้น หยุด และตรวจสอบบริการเหล่านี้ได้
5) ความสามารถในการใช้งานสูงของ Swift Object Storage
โดยทั่วไป ระบบจัดเก็บข้อมูลแบบออบเจกต์แบบกระจายของ OpenStack อย่าง Swift ไม่จำเป็นต้องมีการกำหนดค่าความสามารถในการใช้งานสูง (HA) เพิ่มเติม เนื่องจาก Swift ได้รับการออกแบบด้วยสถาปัตยกรรมแบบกระจาย (ไม่มีโหนดหลัก) พร้อมกลไกทนต่อความผิดพลาด การสำรองข้อมูล การกู้คืนข้อมูล การขยายขนาด และความสามารถในการใช้งานสูง
6) ความพร้อมใช้งานสูงของบริการคิวข้อความ (RabbitMQ)
หาก RabbitMQ ล้มเหลว ข้อความอาจสูญหายได้ สามารถใช้กลไก HA หลายอย่างร่วมกันได้:
ผู้เผยแพร่ยืนยันว่าวิธีการแจ้งเตือนเมื่อมีการเขียนข้อมูลลงดิสก์ในกรณีที่เกิดความล้มเหลว
สามารถใช้กลไกคลัสเตอร์หลายโหนดได้ แต่ความล้มเหลวของโหนดอาจทำให้เกิดความล้มเหลวของคิวได้
โหมดแอคทีฟ-พาสซีฟจะช่วยให้มั่นใจได้ว่าระบบจะสลับไปใช้งานสำรองได้ในกรณีที่เกิดข้อผิดพลาด แต่การเริ่มต้นใช้งานโหนดสำรองอาจมีความล่าช้าหรือล้มเหลวได้
เพื่อการกู้คืนภัยพิบัติและความพร้อมใช้งาน RabbitMQ มีคิวที่คงอยู่ (persistent queues) ซึ่งจัดเก็บข้อความที่ยังไม่ได้ประมวลผลไว้บนดิสก์ในกรณีที่บริการคิวเกิดความล้มเหลว เพื่อป้องกันการสูญเสียข้อความจากการหน่วงเวลาในการส่งและเขียนข้อความ RabbitMQ ได้นำกลไก Publisher Confirm มาใช้เพื่อให้มั่นใจว่าข้อความถูกเขียนลงดิสก์จริงๆ
สำหรับการรองรับคลัสเตอร์ RabbitMQ มีโหมด Active/Passive และ Active/Active ตัวอย่างเช่น ในโหมด Active/Passive เมื่อโหนดหนึ่งล้มเหลว โหนดแพสซีฟจะถูกเปิดใช้งานทันทีและแทนที่โหนดแอคทีฟที่ล้มเหลวเพื่อดำเนินการจัดส่งข้อความต่อไปอย่างรวดเร็ว
การสร้าง OpenStack ที่มีความพร้อมใช้งานสูง
โดยทั่วไป ความพร้อมใช้งานสูงจะเกิดขึ้นได้จากการจัดทำระบบสำรองซ้ำ (redundancy) และการสำรองข้อมูล กลยุทธ์ทั่วไปรวมถึง โหมดคลัสเตอร์ การสำรองข้อมูลระหว่างเครื่องหลายเครื่อง โดยแต่ละอินสแตนซ์จะมีการสำรองข้อมูลหลายครั้ง โดยไม่มีโหนดกลาง เช่น ระบบจัดเก็บข้อมูลแบบกระจายตัวอย่าง Swift และโหมด multi-host ของ nova-network
โหมดอัตโนมัติ ในบางกรณี สามารถแก้ไขปัญหา SPoF ได้โดยอนุญาตให้แต่ละโหนดทำงานอย่างอิสระ โดยไม่มีความสัมพันธ์แบบมาสเตอร์-สเลฟ เพื่อลดผลกระทบจากโหนดควบคุมที่ล้มเหลว ตัวอย่างเช่น nova-api จะรับผิดชอบเฉพาะโหนดของตนเองเท่านั้น
โหมดแอคทีฟ-พาสซีฟ แบบจำลองทั่วไปนี้ประกอบด้วยโหนดพาสซีฟที่อยู่ในสถานะสำรองและพร้อมทำงาน โดยจะเปลี่ยนมาทำงานเมื่อเกิดข้อผิดพลาด ตัวอย่างเช่น คลัสเตอร์ MySQL ความพร้อมใช้งานสูง และบริการต่างๆ เช่น Glance และ Keystone ซึ่งทำให้มีความซ้ำซ้อนได้ผ่าน Pacemaker และ Heartbeat
โหมดแอคทีฟ-แอคทีฟ ในโหมดนี้ โหนดจะสำรองข้อมูลและสนับสนุนกันและกัน เช่น RabbitMQ ใช้คลัสเตอร์ความพร้อมใช้งานสูงแบบแอคทีฟ-แอคทีฟ ซึ่งโหนดในคลัสเตอร์สามารถทำสำเนาคิวได้ จากมุมมองด้านสถาปัตยกรรม แนวทางนี้ช่วยลดความกังวลเกี่ยวกับโหนดพาสซีฟที่ไม่สามารถเริ่มทำงานหรือเกิดความล่าช้าอย่างมาก
โดยสรุป การเพิ่มประสิทธิภาพและการปรับปรุงโอเพ่นสแต็กมีการพัฒนาอย่างต่อเนื่อง และการนำไปใช้งานต่างๆ ก็มีการสำรวจและพัฒนาเพิ่มเติม การปรับแต่งเชิงปฏิบัติจึงมีความสำคัญเป็นอย่างยิ่ง เนื่องจากแนวทางการออกแบบและแนวคิดที่ดีจำเป็นต้องผ่านการทดสอบในโลกแห่งความเป็นจริงเพื่อยืนยันความถูกต้อง
การป้องกัน OpenStack ที่ดียิ่งขึ้น
แม้ว่า OpenStack จะลดความเสี่ยงจากการล้มเหลวของจุดเดียวในระบบผ่านสถาปัตยกรรมสำรองข้อมูลและความพร้อมใช้งานสูง แต่การปกป้องข้อมูลยังคงมีความสำคัญอย่างยิ่ง เพื่อให้มั่นใจในความต่อเนื่องทางธุรกิจ จำเป็นต้องใช้โซลูชันการสำรองข้อมูลระดับมืออาชีพเพื่อป้องกันการสูญหายของข้อมูลและผลกระทบจากความล้มเหลวอย่างร้ายแรง
Vinchin Backup & Recovery เป็นโซลูชันสำรองข้อมูล OpenStack ที่มีความแข็งแกร่ง มอบการสำรองข้อมูลแบบไม่ต้องติดตั้งเอเจนต์และมีประสิทธิภาพ พร้อมคุณสมบัติต่างๆ เช่น การลดทอนข้อมูลซ้ำ การบีบอัดข้อมูล การสำรองข้อมูลแบบเพิ่มเติม การกู้คืนในระดับไฟล์ และคลังข้อมูลบนคลาวด์ เป็นต้น ช่วยให้มั่นใจได้ถึงการกู้คืนข้อมูลอย่างรวดเร็ว การผสานรวมกับ OpenStack อย่างไร้รอยต่อ และความปลอดภัยของข้อมูลที่มั่นคง จึงเป็นตัวเลือกที่เหมาะสมอย่างยิ่งสำหรับการจัดการและปกป้องสภาพแวดล้อมคลาวด์
นอกจากนี้ การเข้ารหัสข้อมูลและการป้องกันแรนซัมแวร์ ยังให้ความคุ้มครองสองชั้นเพื่อปกป้องการสำรองข้อมูล VM บน OpenStack ของคุณ นอกจากนี้ คุณยังสามารถย้ายข้อมูลจากโฮสต์ OpenStack ไปยังแพลตฟอร์มเสมือนอื่นๆ (เช่น VMware, Hyper-V, Proxmox, XenServer, oVirt, AWS EC2...) และในทางกลับกันได้อย่างง่ายดาย
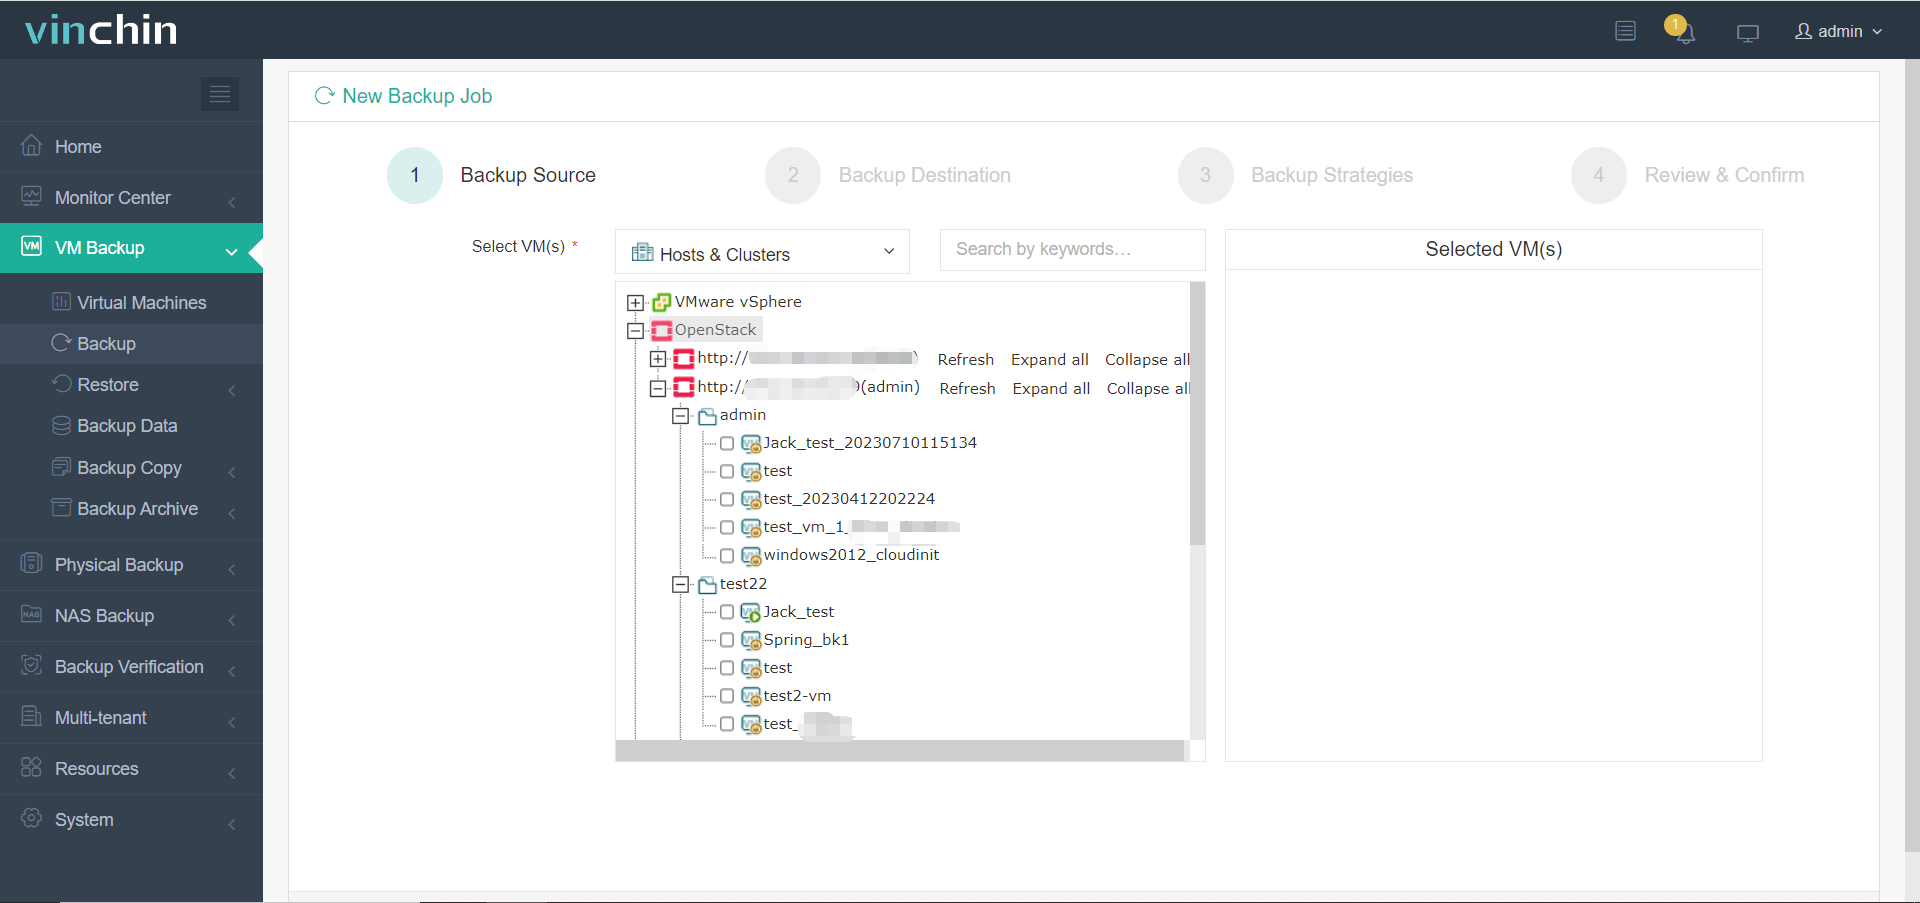
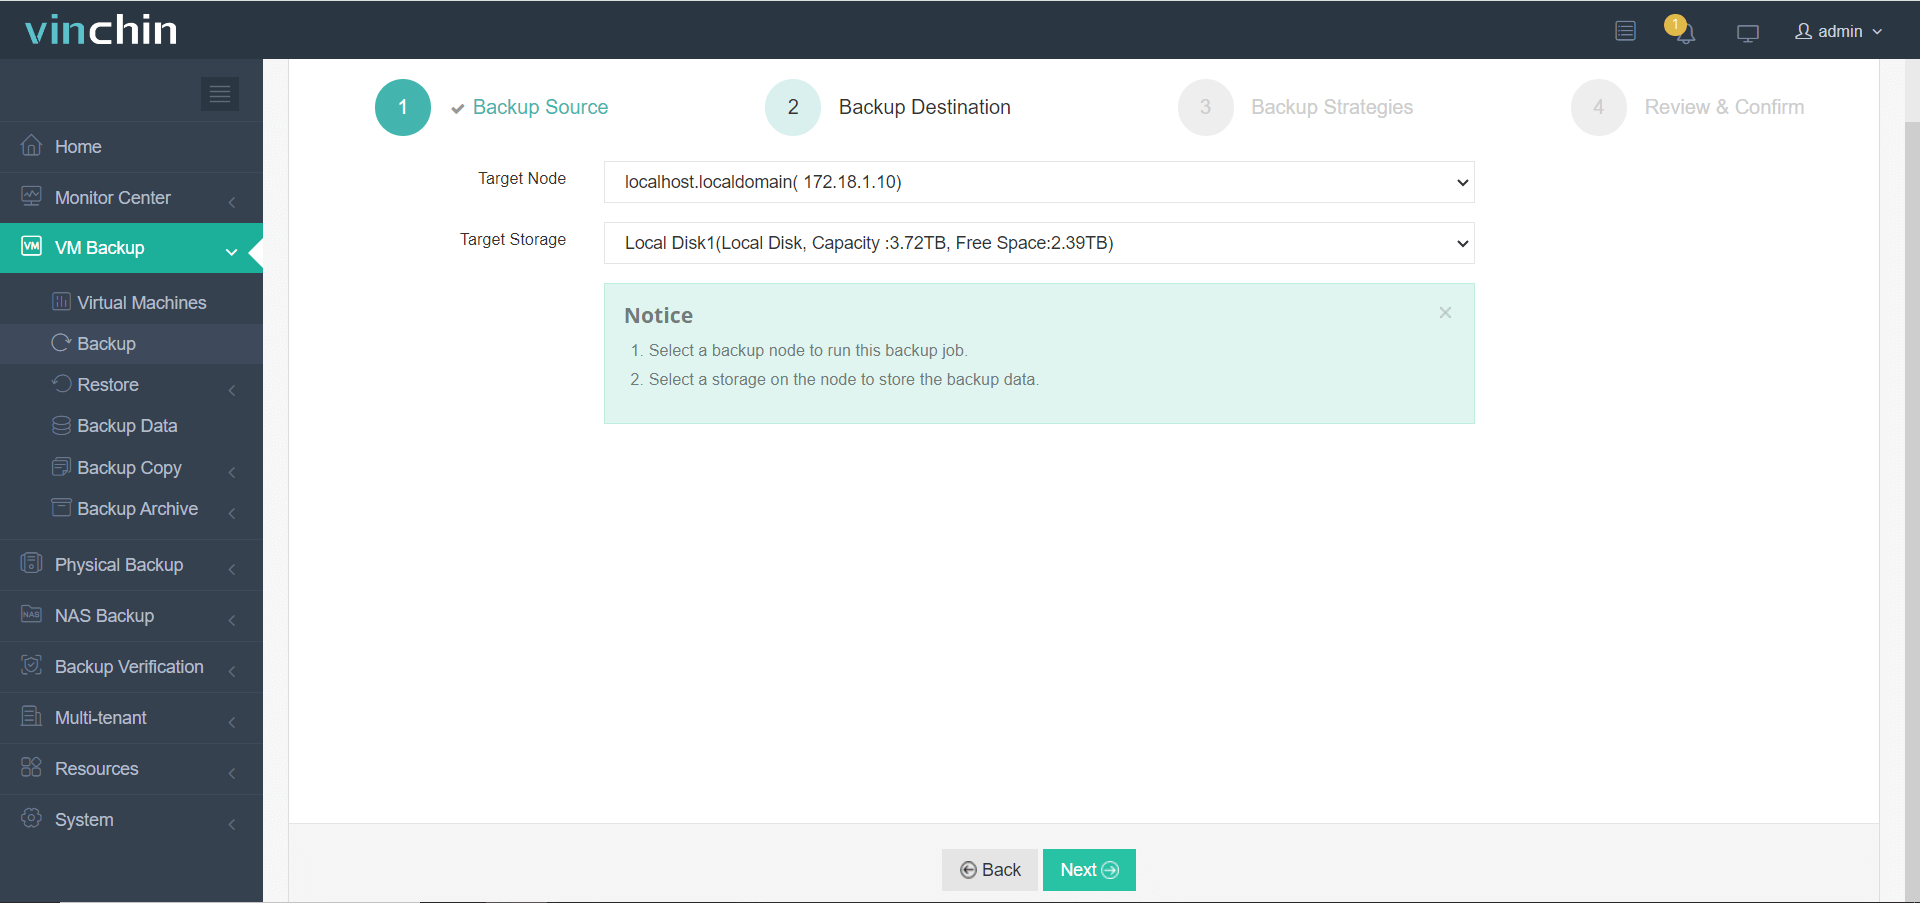
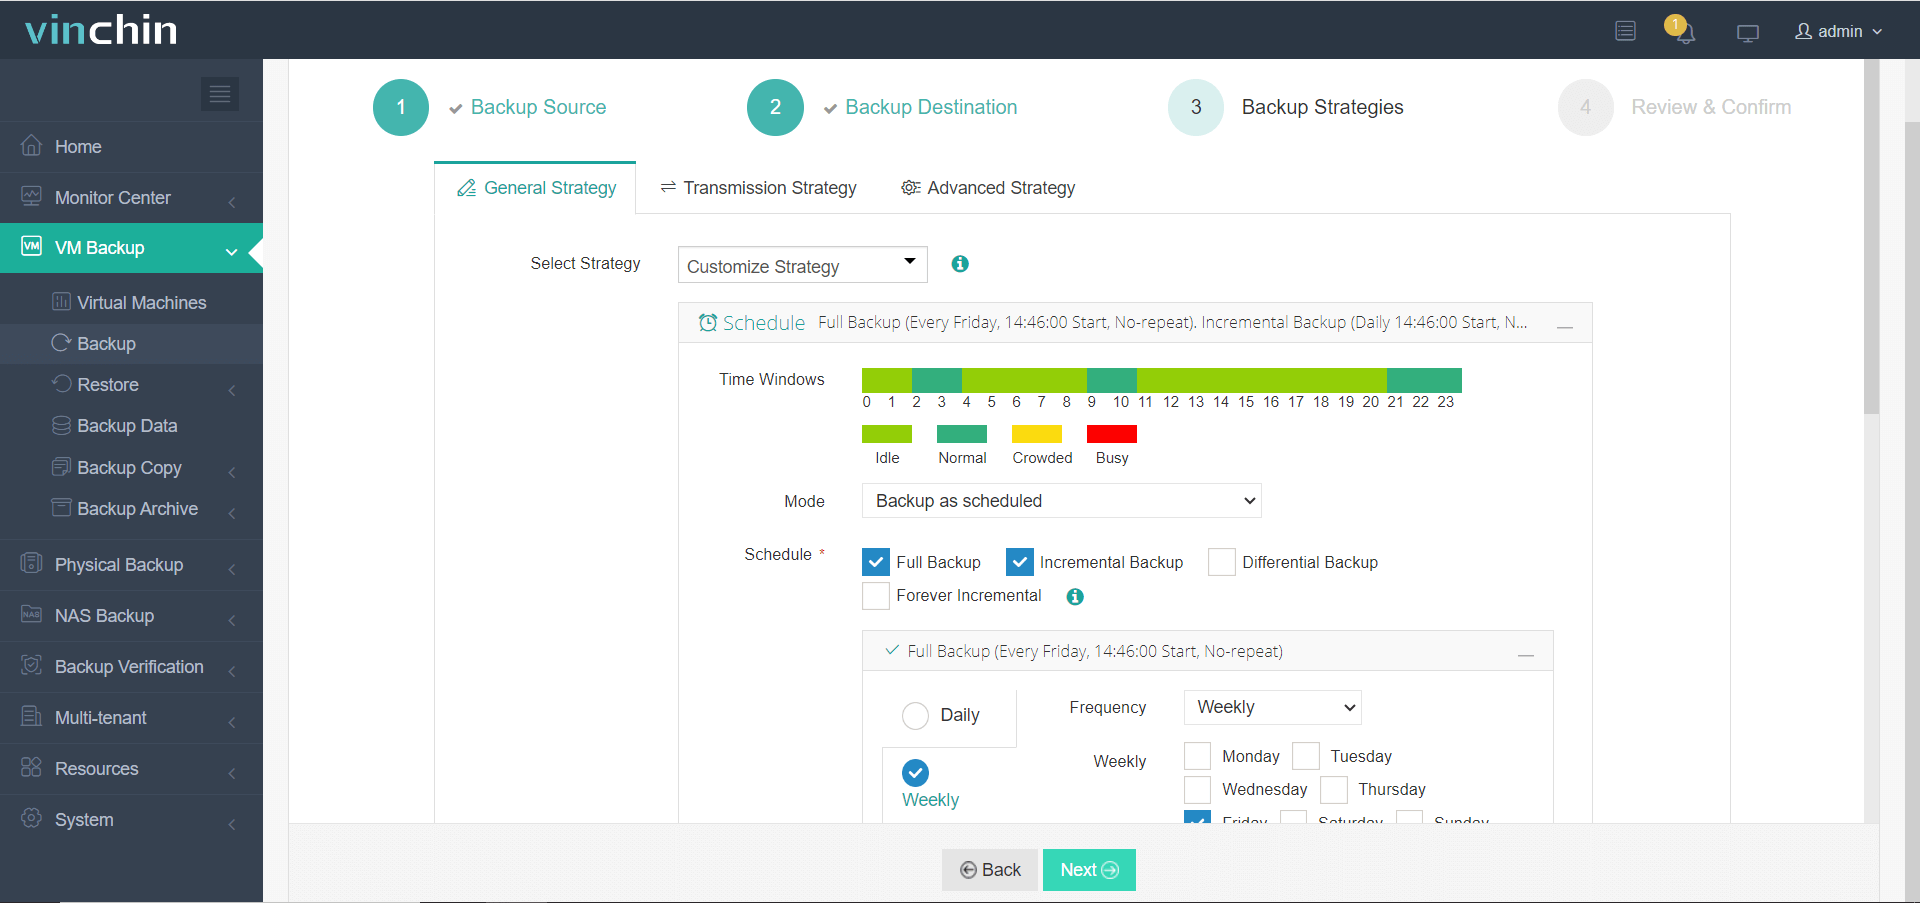
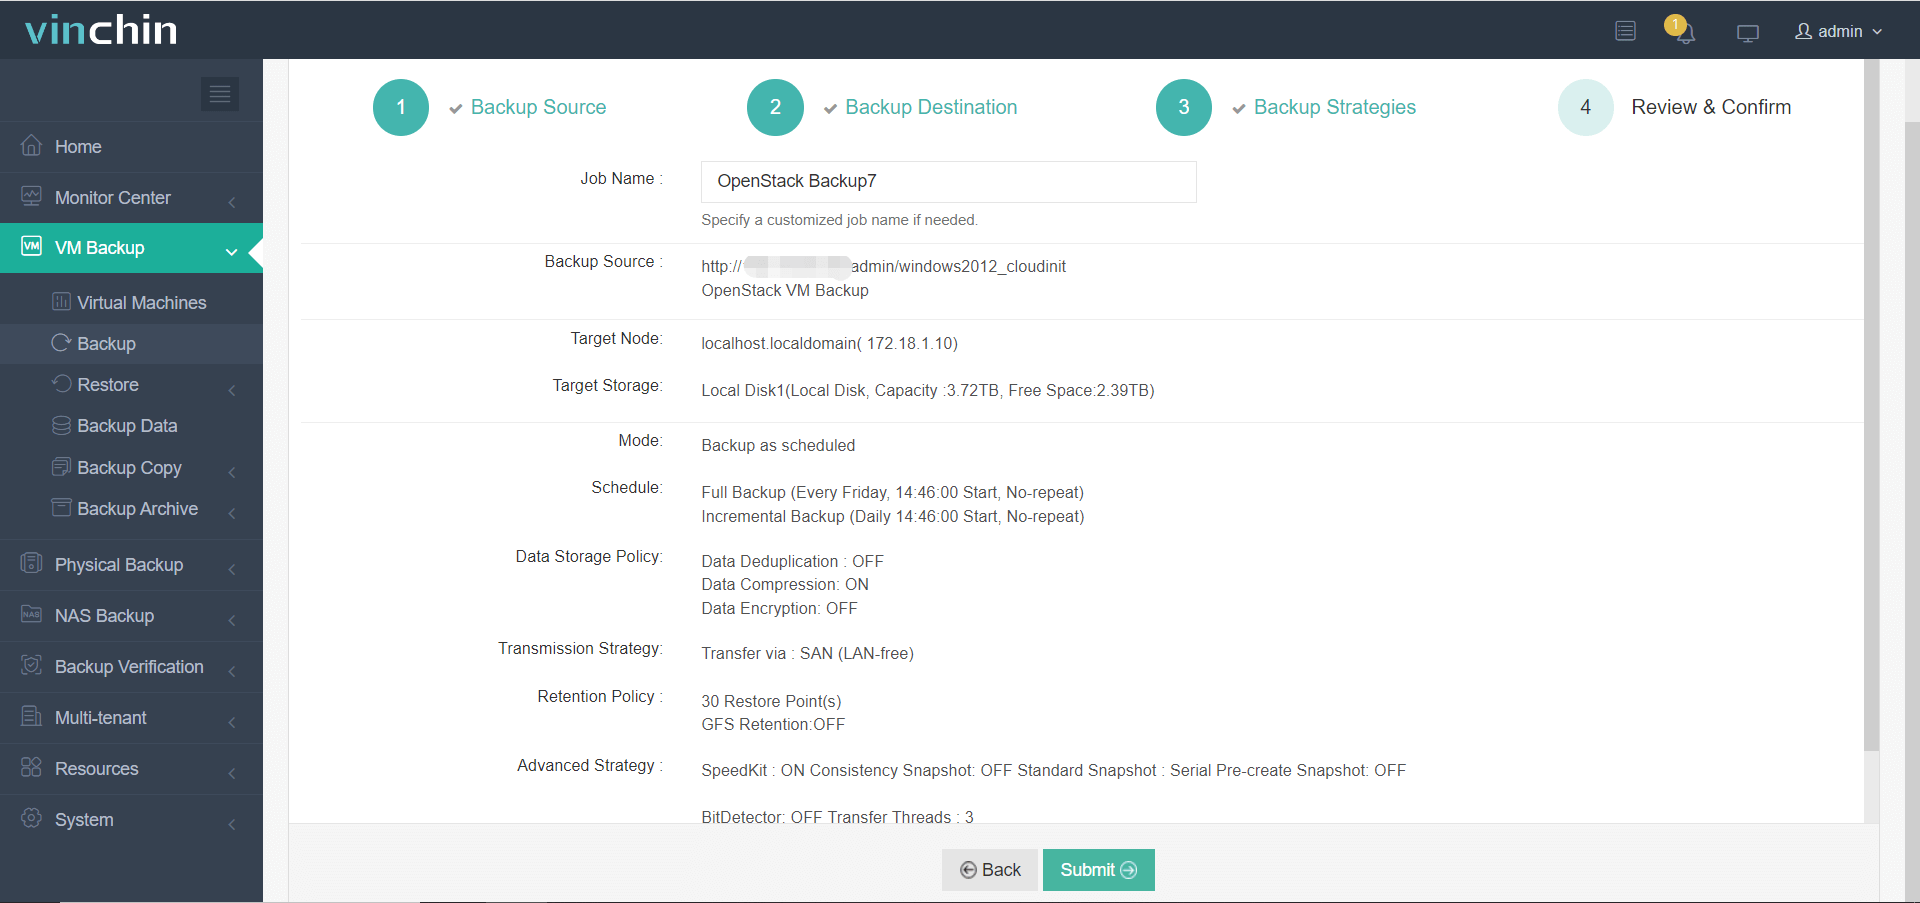
การสำรองข้อมูล OpenStack VM ด้วย Vinchin Backup & Recovery ต้องใช้เพียง 4 ขั้นตอนง่ายๆ ดังนี้:
1. เลือกวัตถุสำหรับการสำรองข้อมูล
2. เลือกปลายทางสำหรับการสำรองข้อมูล
3. กำหนดค่ากลยุทธ์การสำรองข้อมูล
4. ตรวจสอบและส่งงาน
Vinchin Backup & Recovery ได้รับความไว้วางใจจากบริษัทต่างๆ กว่าพันแห่ง เริ่มทดลองใช้งานเต็มรูปแบบ 60 วัน ของคุณได้แล้ววันนี้
คำถามที่พบบ่อยเกี่ยวกับความสามารถในการใช้งานสูงของ Openstack
1. โซนการใช้งานใน OpenStack คืออะไร?
ใน OpenStack พื้นที่ใช้งาน (AZ) คือ การแบ่งส่วนเชิงตรรกะภายในสภาพแวดล้อมคลาวด์ ซึ่งช่วยกระจายภาระงานเพื่อให้มีความทนทานต่อข้อผิดพลาดและการจัดการทรัพยากรที่ดียิ่งขึ้น แต่ละ AZ เป็นโดเมนที่มีความล้มเหลวเป็นอิสระ หมายความว่าอินสแตนซ์ที่อยู่ใน AZ ต่างกันจะได้รับผลกระทบจากปัญหาฮาร์ดแวร์หรือเครือข่ายเดียวกันน้อยลง โดยทั่วไป AZ จะถูกใช้ในการจัดกลุ่มโหนดคอมพิวต์ ขณะที่บริการจัดเก็บข้อมูลและเครือข่ายก็สามารถมีโซนของตนเองเพื่อเพิ่มความทนทานและความสำรองข้อมูลได้ ผู้ใช้สามารถระบุ AZ ได้เมื่อเริ่มต้นใช้งานอินสแตนซ์ เพื่อเพิ่มประสิทธิภาพด้านการทำงานและความน่าเชื่อถือ
2. โอเพ่นสแต็กเป็นซอฟต์แวร์แบบ SAAS หรือ PaaS?
OpenStack เป็นแพลตฟอร์มที่เน้นหลักในรูปแบบ IaaS โดยให้บริการทรัพยากรที่จำลองเสมือนจริง ได้แก่ การประมวลผล การจัดเก็บข้อมูล และเครือข่าย ซึ่งช่วยให้ผู้ใช้งานสามารถติดตั้งและจัดการโครงสร้างพื้นฐานแบบคลาวด์ได้ แม้ว่า OpenStack จะสามารถรองรับโซลูชัน PaaS ได้โดยการเรียกใช้บริการ เช่น Kubernetes หรือ Cloud Foundry บนระบบของมัน แต่หน้าที่หลักของมันคือการให้บริการ IaaS มากกว่า SaaS หรือ PaaS
สรุป
การรับประกันความพร้อมใช้งานสูงใน OpenStack จำเป็นต้องใช้กลยุทธ์ด้านสถาปัตยกรรมและวิธีการทางเทคนิกร่วมกัน เพื่อกำจัดจุดบกพร่องที่เป็นหน่วยเดียว และเพิ่มความทนทานของระบบ โดยการนำโหมด active-passive และ active-active มาใช้ อาศัยเทคนิคการจัดกลุ่ม (clustering) และการปรับให้ส่วนประกอบหลัก เช่น Nova, Glance, Keystone และ RabbitMQ มีประสิทธิภาพสูงสุด ทำให้ OpenStack สามารถบรรลุโครงสร้างพื้นฐานคลาวด์ที่ทนต่อข้อผิดพลาดและเชื่อถือได้สูง นอกจากนี้ โซลูชันการจัดเก็บข้อมูลแบบกระจาย เช่น Swift มีความสามารถในการสำรองข้อมูลและความทนทานโดยธรรมชาติ