Le imprese si trovano di fronte a rischi crescenti come gli attacchi cibernetici e i disastri naturali. Il ripristino di emergenza cloud ibrido combina sistemi on-premise e strumenti cloud per proteggere dati e operazioni. Bilancia controllo, flessibilità e costo.
Cos'è la Ricostruzione da Disastro su Nuvola Ibrida?
La ricostruzione da disastro su nuvola ibrida utilizza insieme sistemi locali e piattaforme cloud per proteggere i dati e mantenere le applicazioni in funzione durante interruzioni. Copia continuamente i dati fuori sito e automatizza i processi di failover. I carichi di lavoro sensibili rimangono on-premise per motivi di conformità, mentre il cloud si espande a richiesta e gestisce picchi improvvisi di traffico.
Un piano di DR per il cloud ibrido è una strategia formalizzata che combina l'infrastruttura on-premises con uno o più cloud pubblici o privati per soddisfare obiettivi definiti di Recovery Time Objectives (RTO) e Recovery Point Objectives (RPO). L'automazione garantisce un numero minimo di passaggi manuali, riducendo gli errori umani e accelerando il recupero.
Confronto con Altri Modelli
Il DR tradizionale si basa esclusivamente su un secondo data center, spesso a costo elevato e con una scalabilità più lenta.
Il DR esclusivamente basato sul cloud offre una rapida scalabilità, ma potrebbe sollevare preoccupazioni relative al compliance per i carichi di lavoro regolamentati.
Hybrid DR combina entrambi, offrendo il controllo sui dati sensibili e un'elasticità cost-effectively.
Perché importa il DR del Cloud ibrido?
Elimina i singoli punti di errore
Riproducendo i dati in una regione cloud geograficamente separata, si protegge contro disastri a livello di sito come interruzioni elettriche o eventi naturali. L'utilizzo di Multi-AZ all'interno di una regione protegge dagli errori a livello di rack; l'architettura ibrida estende questa protezione alla resilienza a livello di regione.
Controllo del bilanciamento e scalabilità
I dispositivi in locale mantengono il controllo dei dati regolamentati; il cloud bursting accoglie picchi imprevedibili di traffico con una capacità virtualmente infinita. Questa dualità evita un costoso oversizing degli apparecchi on-prem mantenendo comunque i livelli di servizio richiesti dalla conformità.
Riduci i costi di archiviazione
Implementa criteri lifecycle per passare i punti di recupero più vecchi a livelli di oggetti a costo ridotto, riducendo i costi di conservazione a lungo termine fino al 70 %. Usa il tagging per automatizzare le transizioni dei livelli in base all'età o al tipo di backup.
Contrasto al Ransomware
I backup immutabili in archivi write-once, read-many (WORM) impediscono il ciframento da parte dei malware. Le repliche isolate e i criteri di blocco degli archivi garantisco l'integrità dei dati anche se i siti primari vengono compromessi.
Sfide del Hybrid Cloud DR
Latenza di Rete
Le lunghe distanze tra i data center e i siti cloud aggiungono un ritardo di andata e ritorno. Per mantenere la replica quasi in tempo reale, le organizzazioni devono:
Ottimizza i collegamenti utilizzando la priorizzazione del traffico e la compressione per ridurre la latenza effettiva.
Usa circuiti dedicati o connessioni gestite per evitare la congestione del pubblico internet.
Implementare la memorizzazione nella cache dei bordi o gli acceleratori di protocollo che riducono l'overhead della stretta di mano e le ritrasmissioni.
Costi Imprevedibili
I provider cloud spesso non addebitano i trasferimenti in entrata ma addebitano quelli in uscita, l'uso delle API e il recupero dai livelli di archiviazione a lungo termine. Per controllare i costi:
Prevedere il consumo simulando i picchi di carico e misurando i pattern di uscita.
Imposta budget e avvisi per il storage, la rete e il calcolo.
Archivia e gestisci automaticamente i backup inattivi—trasferisci snapshot più vecchi a classi di archiviazione a costo inferiore.
Breccie di Sicurezza
Mescolare ambienti on-premises e cloud può lasciare controlli di accesso incoerenti e gestione delle chiavi:
Unificare l'identità integrando i servizi di directory locali con l'IAM cloud, applicando le stesse funzioni con privilegi minimi ovunque.
Centralizza la crittografia con un processo di gestione delle chiavi condivise che ruota le chiavi regolarmente e registra ogni utilizzo.
Rinforza i punti finali assicurandoti che tutti gli agenti di backup, i gateway e le console eseguano patch di sicurezza aggiornate.
Compatibilità Applicazioni Legacy
I sistemi più vecchi potrebbero non supportare nativamente i metodi di replica moderni:
Cattura a livello virtuale istantanee di interi dischi e stato della memoria delle VM per evitare la necessità di agenti all'interno degli ospiti.
I contenitori o le shim ti permettono di incapsulare applicazioni legacy in un ambiente di esecuzione leggero che espone API standard.
I connettori personalizzati traducono i flussi di dati proprietari in flussi a livello di blocco o file generici.
Best Practice per il DR del Hybrid Cloud
Classifica i Dati
Etichetta correttamente ogni workload in base al suo impatto sul business e alle esigenze di conformità:
Tier-1 (Critico): Replica senza perdita di dati, sincrona o quasi sincrona.
Livello-2 (Importante): Replica asincrona frequente (RPO a livello di minuti).
Tier-3 (Non critico): Backup periodico solo.
Automatizza l'etichettatura in anticipo in modo che le nuove VM e i database ereditino automaticamente le impostazioni di DR corrette.
Testa Regolarmente
Pianifica e automatizza esercitazioni trimestrali di failover che riflettano la tua topologia di produzione:
Utilizza account o aree isolate “sandbox” che hanno lo stesso layout di rete, calcolo e archiviazione.
Test end-to-end dei script—from provisioning del sito di recupero alla validazione dell'applicazione—perché riesci a individuare le configurazioni errate prima degli incidenti reali.
Automatizza completamente
Trasforma ogni passaggio manuale di DR in codice e flussi di lavoro basati su eventi:
I modelli Infrastructure as Code configurano gli ambienti DR su richiesta.
I libri di orchestrazione attivano le sequenze di ripristino automaticamente quando il sito primario va offline.
Gli hook degli eventi avviano controlli delle dipendenze, verifiche della salute e notifiche senza intervento umano.
Backup Sicuri
Proteggi i dati di backup sia inattivi che durante il trasferimento:
La crittografia con chiave suddivisa mantiene metà di ogni chiave in locale e l'altra metà in un cofano cloud sicuro.
Il retention immutabile impedisce l'eliminazione o la modifica degli snapshot archiviati per un periodo definito.
Le tracce di audit catturano ogni accesso e operazione, integrandosi nel tuo SIEM per un monitoraggio continuo.
Monitora le Prestazioni
Misura costantemente la salute della replica e l'uso delle risorse:
Le metriche di ritardo mostrano quanto i repliche secondarie siano indietro rispetto alla fonte.
I tracciatori di I/O e larghezza di banda evidenziano i punti di soffocamento prima che violino le soglie RPO.
Gli avvisi automatizzati e i workflow di autocorrezione possono riavviare i compiti in ritardo, riallocare la throughput o attivare buffer temporanei quando vengono superate le soglie.
Soluzione di Ripristino da Disastri Hibrida Vinchin
Basandosi sulle migliori pratiche illustrate sopra, la soluzione DR ibrida di Vinchin offre un completo set di funzionalità per proteggere i tuoi ambienti virtuali e mantenere le operazioni in funzione senza intoppi.
Vinchin offre il ripristino istantaneo delle macchine virtuali istant recovery, permettendoti di avviare qualsiasi VM direttamente da un backup in quanto poco come 15 secondi. Puoi archiviare i backup nelle tier di archiviazione cloud per la conservazione a lungo termine tramite policy GFS. Vinchin consente anche il backup su nastro, lavorando con sia le librerie di nastri fisiche che virtuali per il vaulting offline. La replica del backup remoto sincronizza automaticamente le copie dei vault nei siti remoti.
Per un RPO prossimo a zero, Vinchin offre una protezione continua dei dati (CDP) per catturare ogni transazione in tempo reale. È possibile applicare il GFS retention per soddisfare i requisiti di conformità per i backup settimanali, mensili e annuali. La piattaforma esegue la verifica dei dati di backup delle VM attraverso il test di avvio dei backup in un laboratorio isolato per garantire la recuperabilità. Infine, il ripristino granulare consente di recuperare singoli file o cartelle senza dover effettuare il ripristino completo della VM.
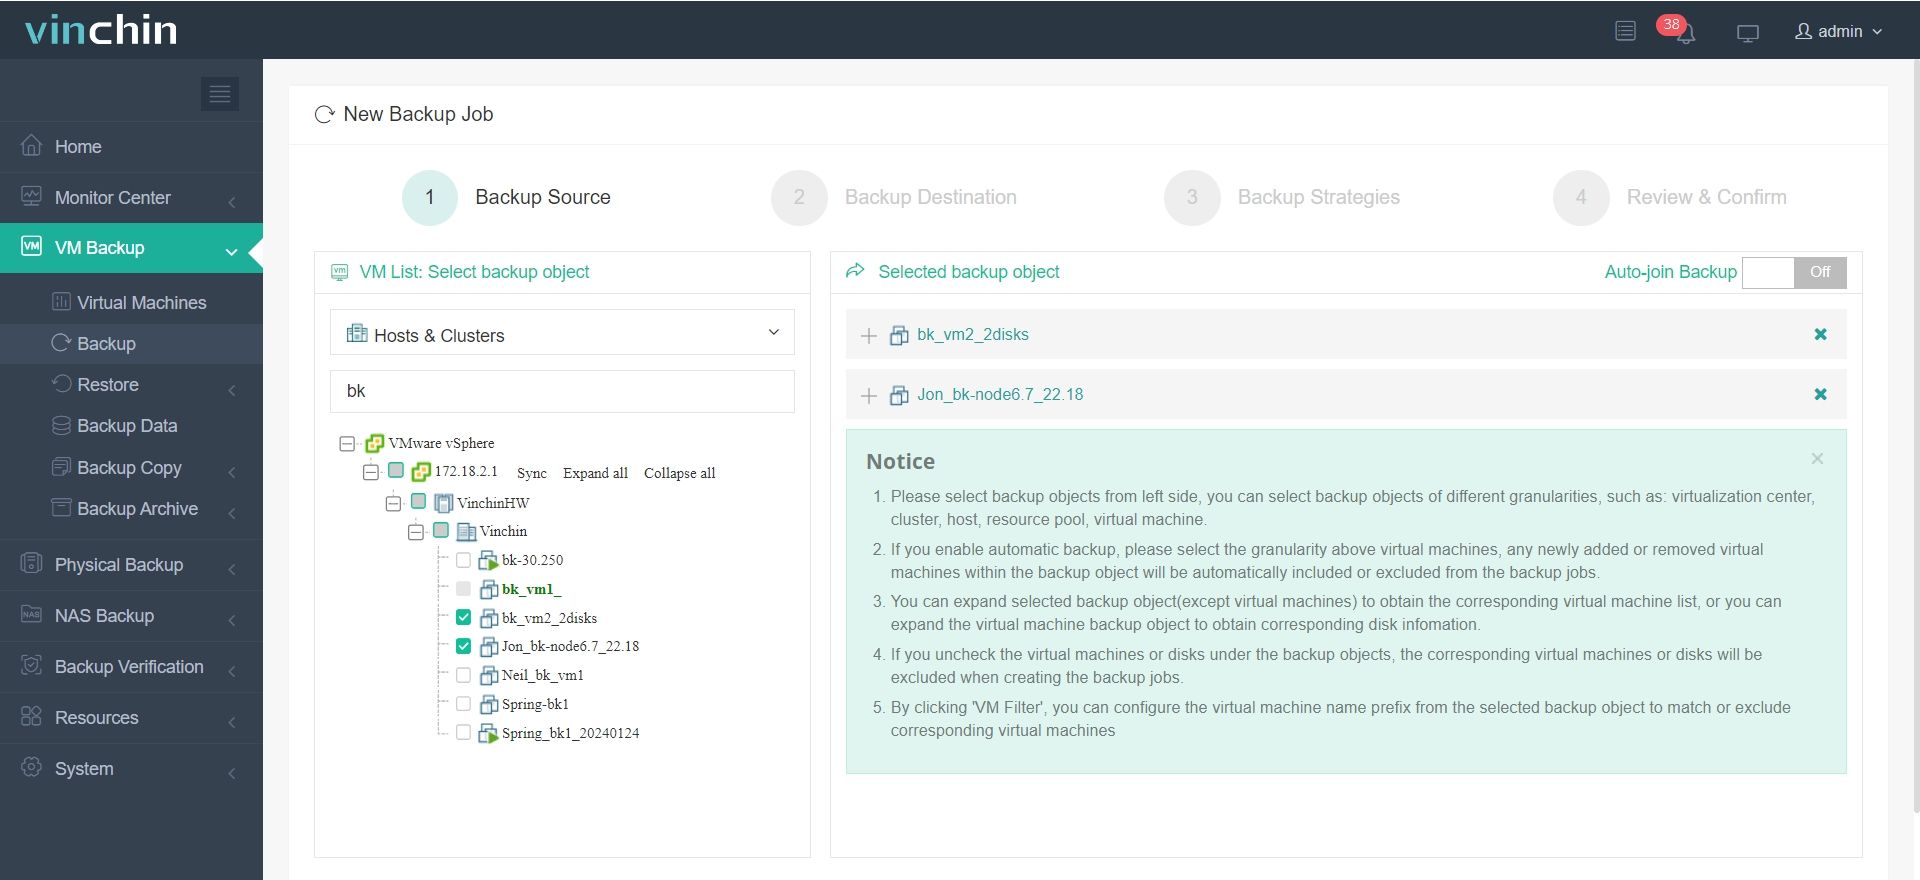
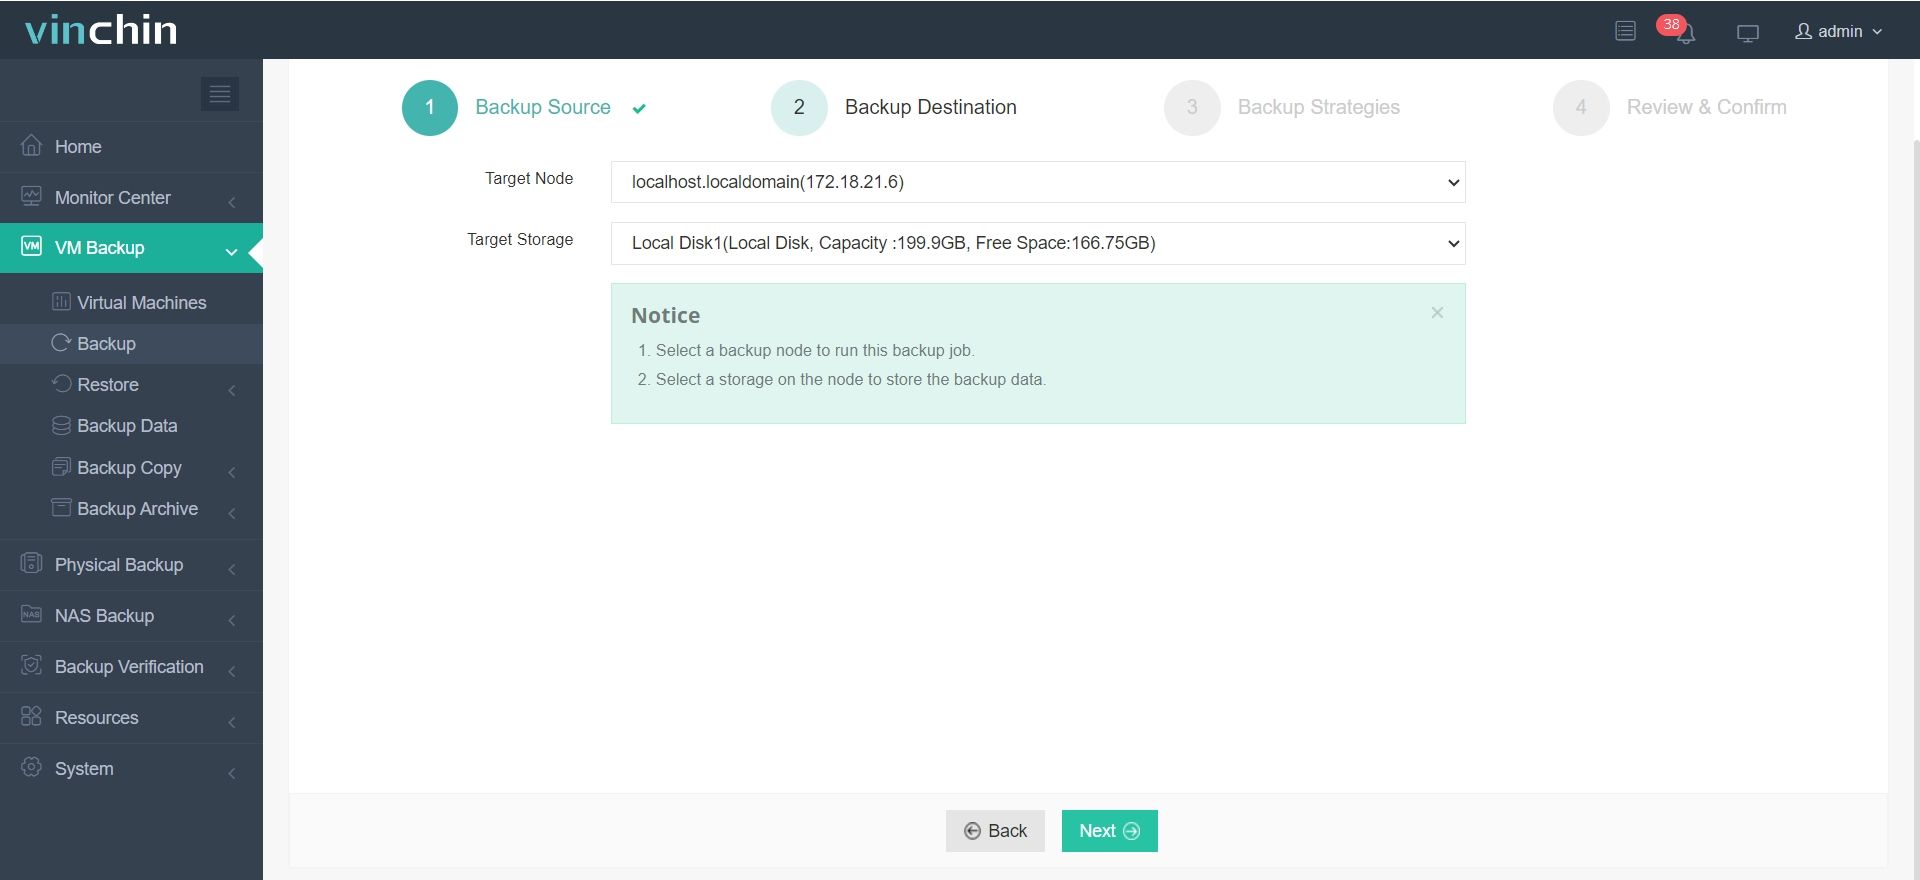
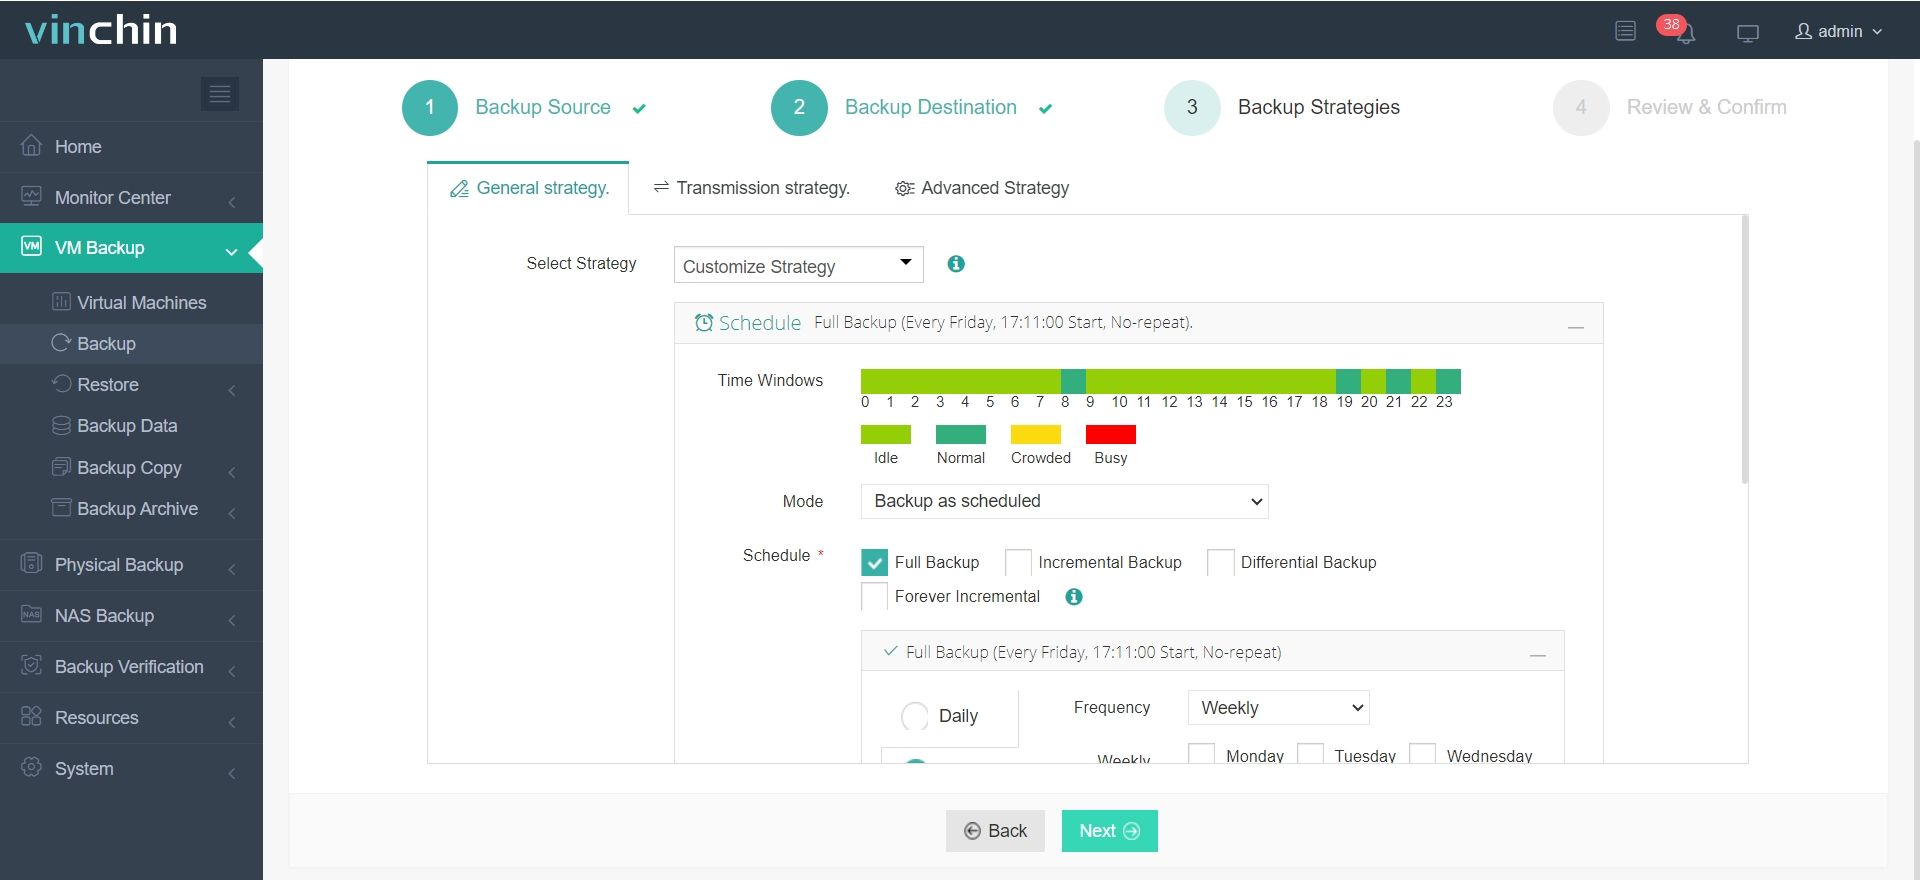
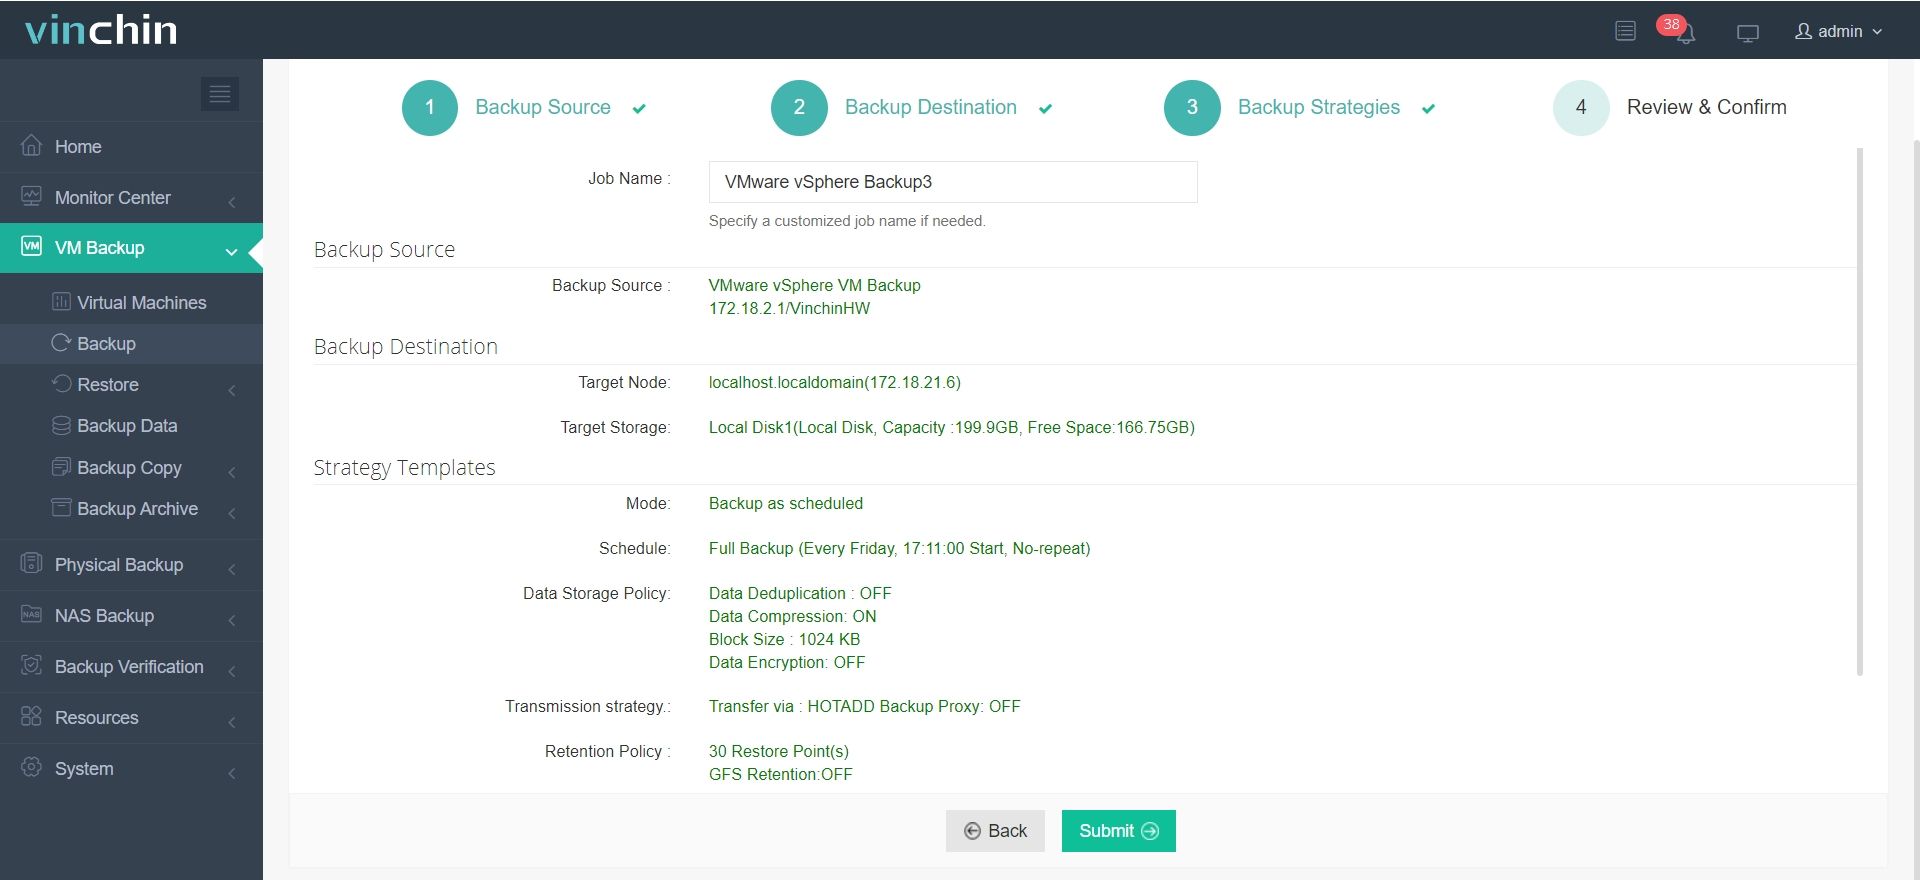
Con la console web intuitiva di Vinchin, il deploy del ripristino dopo disastro nel cloud ibrido richiede solo quattro passaggi:
1. Seleziona la VM che desideri backuppare
2. Scegli il datastore di backup
3. Definisci la strategia di backup
4. Invia il lavoro
Unisciti a oltre 30000 imprese globali che fidano nella soluzione top-rated di Vinchin. Inizia oggi la tua versione di prova gratuita di 60 giorni con tutte le funzionalità e scopri quanto facilmente puoi proteggere i workload critici. Clicca su DOWNLOAD per effettuare il deployment in pochi minuti.
FAQ sul DR del cloud ibrido
Q1: Cosa rende il DR del cloud ibrido unico?
A: Combina il controllo on-premises con la velocità del cloud, evitando il vincolo del fornitore.
Q2: Qual è la sfida tecnica principale del ripristino disaster in cloud ibrido?
A: Mantenere i ritardi di rete sotto i 15ms per i backup in tempo reale.
Q3: Come si possono ridurre i costi di DR nel cloud ibrido?
A: Archivia i vecchi backup in un archivio cloud a basso costo (Glacier) e sincronizza solo i dati critici.
Conclusione
Il ripristino di emergenza nel cloud ibrido offre un percorso pratico per le aziende. Consente di mantenere i dati sensibili al sicuro in locale mentre utilizza il potenziale del cloud in caso di emergenza. Automatizzando i processi, testando i piani e gestendo i costi, le organizzazioni possono affrontare le interruzioni con fiducia.
Per proteggere meglio il tuo carico di lavoro, scarica Vinchin per proteggere i dati in ogni modo. Non perdere il periodo di prova gratuito.