W epoce obliczeń chmurowych i danych dużych, ogromny wzrost objętości danych stwarza nowe wyzwania dla ich przechowywania i ochrony. Postęp technologiczny, reprezentowany przez architekturę chmurową, wirtualizację i hiperkonwergencję, doprowadził do iteracyjnych ulepszeń, przyspieszając metody ochrony danych.
Ten wpis przedstawi podstawowe koncepcje ochrony danych oraz pokaże, jak chronić dane firmowe i zapewnić ciągłość działania biznesowego.
Czym jest ochrona danych?
Ochrona danych polega na stosowaniu odpowiednich środków technicznych i organizacyjnych w celu zapobieżenia nieuprawnionemu dostępowi, zmianie, ujawnieniu lub zniszczeniu danych przez podmioty trzecie lub osoby posiadające do tego uprawnienia, co umożliwia zapewnienie bezpieczeństwa danych.
Ochrona danych obejmuje dwa aspekty: ochronę logiczną i ochronę fizyczną. Ochrona logiczna obejmuje bezpieczeństwo bazy danych, bezpieczeństwo oprogramowania, bezpieczeństwo sieci, ochronę punktów końcowych i inne. Ochrona fizyczna obejmuje zaszyfrowane przesyłanie danych, podpisy elektroniczne, systemy monitoringu wizyjnego (CCTV) oraz inne.
Ochrona danych obejmuje również wymagania biznesowe i prawne, takie jak przepisy dotyczące ochrony prywatności. W zakresie bezpieczeństwa danych zarówno rządy narodowe, jak i lokalne posiadają własne ustawy i regulacje, które określają sposób, w jaki firmy muszą obchodzić się z danymi osobowymi, wdrażać mechanizmy ochrony danych oparte na prywatności oraz ograniczać naruszenia przepisów.
Dlaczego ochrona danych jest tak ważna?
Dane to kluczowy zasób dla przedsiębiorstw, a utrata danych krytycznych może zadać śmiertelny cios dla firmy. Na przykład, w wyniku ataków 11 września Bank of New York został zmuszony do upadłości i likwidacji przez utratę danych.
Dlaczego konsekwencje są tak poważne? Dlatego, że dane są powodem i fundamentem istnienia systemów komputerowych, które często są niezastąpione. Gdy wystąpi utrata danych, przedsiębiorstwa mogą znaleźć się w trudnej sytuacji – informacje o klientach, dokumentacja techniczna, zapisy finansowe oraz inne kluczowe dane związane z klientami, transakcjami i produkcją mogą zostać zniszczone niemal bezpowrotnie.
Dla instytucji finansowych, takich jak banki, konieczne jest przestrzeganie przepisów dotyczących wymogów przechowywania danych, co będzie korzystne zarówno dla banków, jak i klientów.
Podsumowując, utrata danych może wystąpić na trzech poziomach. Po pierwsze, są błędy logiczne, w tym błędy oprogramowania, ataki wirusów i uszkodzenie danych. Po drugie, występuje uszkodzenie fizyczne, takie jak awaria serwera lub dysku. Po trzecie, istnieją klęski żywiołowe, które mogą zniszczyć centrum danych.
Ryzyko związane z utratą danych jest zawsze obecne. Incydenty takie jak "celowe usuwanie baz danych, tylni dostęp do luk w zabezpieczeniach, wrodzone podatności systemów, błędy dostawców usług chmurowych, pomyłki w konfiguracji oraz pożary centrów danych" stanowią bolesne lekcje w dziedzinie utraty danych.
Prywatność danych
Prywatność danych, nazywana również ochroną informacji, to aspekt ochrony danych, który dotyczy prawidłowego przechowywania, dostępu, zapisywania, niezmienności i bezpieczeństwa danych wrażliwych.
Ochrona prywatności danych jest podzbiorem szerszego pojęcia ochrony danych. Obejmuje ona tradycyjną ochronę danych — taką jak tworzenie kopii zapasowych i uwzględnianie aspektów odzyskiwania danych po katastrofie — oraz bezpieczeństwo danych. Celem ochrony danych jest zapewnienie ciągłej prywatności i bezpieczeństwa wrażliwych danych firmowych, przy jednoczesnym zapewnieniu dostępności, spójności i niezmienności tych danych.
Ochrona danych prywatnych jest zazwyczaj kojarzona z właściwym zarządzaniem danymi osobowymi lub informacjami umożliwiającymi identyfikację osoby (PII), takimi jak imiona, adresy, numery ubezpieczenia społecznego i numery kart kredytowych. Jednak pojęcie to obejmuje również inne wartościowe lub poufne dane, w tym dane finansowe, własność intelektualną oraz informacje o zdrowiu osobistym. Wytyczne dotyczące ochrony danych w specyficznych sektorach często regulują inicjatywy związane z ochroną prywatności i zabezpieczeniem danych, a także wymagania prawne różnych organów regulacyjnych i jurysdykcji.
Ochrona prywatności danych nie jest pojedynczym pojęciem czy podejściem. Jest to raczej dziedzina obejmująca zasady, praktyki, wytyczne i narzędzia, które pomagają organizacjom tworzyć i utrzymywać wymagane poziomy zgodności w zakresie prywatności.
Jak chronić swoje dane za pomocą kopii zapasowej?
Niezależnie od tego, czy jesteś firmą, czy osobą prywatną, możesz wykonywać kopie zapasowe danych. Kopia zapasowa to kopia wcześniej zdefiniowanego zbioru danych i jest podstawową metodą ochrony danych. Odzwierciedla ona statyczny stan danego zbioru w określonym momencie. Pliki kopii zapasowej stanowią fundament każdej architektury ochrony danych, a ich celem jest ułatwienie odzyskiwania informacji.
Pod względem ewolucji architektury kopii zapasowych wyróżnia się cztery typy: kopia zapasowa lokalna, kopia zapasowa sieciowa, kopia zapasowa LAN-Free (SAN) oraz kopia zapasowa Server-Free .
Kopia zapasowa lokalna: Ma zalety szybkiego tworzenia kopii zapasowych i prostego systemu. Jednak nie nadaje się do środowisk wielohostowych, które wymagają skomplikowanego zarządzania.
Kopia zapasowa sieciowa: oferuje scentralizowane tworzenie kopii zapasowych i zarządzanie nimi, w pełni wykorzystując zasoby biblioteki taśmowej. Jednakże, zużywa zasoby sieciowe, a w przypadku tworzenia kopii dużych ilości danych pojawiają się wąskie gardła sieciowe.
Kopia zapasowa LAN-Free (SAN): Zapewnia szybkie tempo tworzenia kopii zapasowych i eliminuje wąskie gardła spowodowane przez tradycyjne sieci. Jest odpowiednia do szybkiego tworzenia kopii dużych ilości danych, jednak zwykle jest droższa.
Tworzenie kopii zapasowych bez serwera: Ma ona tę zaletę, że nie powoduje dodatkowych kosztów na serwerach produkcyjnych i zapewnia brak degradacji wydajności systemu produkcyjnego. Wymaga jednak specjalistycznego sprzętu.
W zakresie ewolucji technologii tworzenia kopii zapasowych, odbywa się ona wzdłuż ścieżki obejmującej tworzenie kopii zapasowych planowanych – migawek – oraz tworzenie kopii zapasowych w czasie rzeczywistym.
Planowane kopie zapasowe: Mają przewagę w zakresie wsparcia dla szerokiego wachlarza oprogramowania i sprzętu, są odpowiednie do długoterminowego przechowywania danych. Jednakże wymagają one otwierania plików w celu wykonania kopii zapasowej, co może prowadzić do problemów z niespójnością danych, gdy pliki w folderach ulegają zmianie. Dodatkowo wymagają one przydzielenia dedykowanego czasu na wykonanie kopii zapasowej, co skutkuje długim czasem odzyskiwania danych (RPO).
Backup migawki: Został zaprojektowany aby rozwiązać problemy związane ze zmianami plików podczas tworzenia kopii zapasowej. Jednakże backup migawki może napotykać problemy ze zgodnością oraz znacząco wpływać na wydajność systemów produkcyjnych. Dodatkowo, prowadzi również do dłuższego RPO.
Replikacja w czasie rzeczywistym (taka jak CDP): Została opracowana, aby rozwiązać problemy związane ze zmianami plików podczas tworzenia kopii zapasowych oraz ograniczoną kompatybilnością migawek. Umożliwia odzyskiwanie danych w dowolnym momencie, osiągając RPO≈zero.
Jak zagwarantować ciągłość działalności przy pomocy odzyskiwania po katastrofie?
Dla przedsiębiorstw i organizacji kopie zapasowe są często łączone z odzyskiwaniem po katastrofach. Kopie zapasowe chronią dane, natomiast odzyskiwanie po katastrofie zapewnia ciągłość działania na podstawie tych kopii. Z tego punktu widzenia odzyskiwanie po katastrofie dzieli się zazwyczaj na odzyskiwanie danych i odzyskiwanie aplikacji.
Odzyskiwanie danych po katastrofie oznacza utworzenie zdalnego systemu danych, który zapewnia replikację w czasie rzeczywistym kluczowych danych aplikacji z lokalnej witryny.
Odzyskiwanie aplikacji po katastrofie oznacza utworzenie kompletnego rezerwowego systemu aplikacji w oddalonym miejscu na bazie odzyskiwania danych po katastrofie. W przypadku wystąpienia katastrofy, system rezerwowy szybko przejmuje operacje biznesowe.
W przypadku rozważania kopii zapasowych i odzyskiwania po katastrofach należy podkreślić dwa pojęcia:
Punkt odbudowy (RPO) to moment w czasie, do którego system odzyskiwania danych po awarii może przywrócić dane po wystąpieniu katastrofy. Mierzy on ilość danych, które przedsiębiorstwo może pozwolić sobie stracić. RPO można określić jako maksymalnie akceptowalną utratę danych dla organizacji.
Czas odbudowy (RTO) to przedział czasowy od momentu awarii systemu i przerwania operacji biznesowych do momentu przywrócenia systemu i możliwości wspierania działów biznesowych w возnowieniu działalności. RTO można określić jako akceptowalny czas odbudowy dla organizacji.
Różnice między kopią zapasową a odzyskiwaniem po katastrofie
Kopia zapasowa i odzyskiwanie po katastrofie to rzeczywiście odrębne pojęcia. Kopia zapasowa to proces ochrony danych, podczas gdy odzyskiwanie po katastrofie skupia się na zapewnieniu ciągłości działalności firmy. Wraz z pojawieniem się zintegrowanych rozwiązań odzyskiwania po katastrofach, oba te pojęcia są często łączone, co może prowadzić do zamieszania w momencie, gdy użytkownicy kupują produkty oprogramowania, tak że producent może nie zagwarantować, czy użytkownicy potrzebują produktów do tworzenia kopii zapasowych, czy też produktów do odzyskiwania po katastrofie, albo oczekują kombinacji obu.
Odzyskiwanie po katastrofie jest głównym celem, podczas gdy tworzenie kopii zapasowych to jedno z narzędzi do jego osiągnięcia, a nie jedyna metoda. Tworzenie kopii zapasowych polega na generowaniu kopii danych i przechowywaniu ich na różnych nośnikach, zapewniając możliwość odzyskania danych w przypadku ich utraty. Jednak same kopie zapasowe nie gwarantują odzyskania po katastrofie. Kopie zapasowe są częścią szerszego pojęcia jakim jest odzyskiwanie po katastrofach, które obejmuje wdrażanie różnych środków technicznych w celu zapewnienia ciągłości działalności firmy.
W scenariuszu odzyskiwania po katastrofie celem jest zapewnienie, że operacje biznesowe nie zostaną przerwane lub mogą zostać automatycznie przywrócone po nieoczekiwanym zdarzeniu. Wymaga to wdrożenia środków technicznych w celu ochrony każdego komponentu, takiego jak serwery, sieci i systemy pamięci masowej. Kopiowanie zapasowe to tylko jeden z aspektów odzyskiwania po katastrofie, a głównym celem jest zapewnienie nieprzerwanej działalności biznesowej.
Podsumowując, kopie zapasowe i odzyskiwanie po katastrofach to dwa odrębne pojęcia. Kopia zapasowa to metoda ochrony danych, natomiast odzyskiwanie po katastrofach to szerszy cel zapewnienia ciągłości działalności firmy. Kopia zapasowa to jeden ze sposobów osiągnięcia odzyskiwania po katastrofach, jednak do kompleksowego zapewnienia takiej możliwości wymagane są dodatkowe środki.
Zasada ochrony danych
Zasady ochrony danych to zestaw podstawowych wytycznych określających, w jaki sposób powinno się przetwarzać i chronić dane osobowe. Zasady te są często wprowadzane do ustaw i regulaminów dotyczących ochrony danych. Choć konkretne zasady mogą się nieznacznie różnić w zależności od jurysdykcji, poniżej przedstawiono powszechnie uznawane zasady ochrony danych zgodnie z RODO:
Ochrona danych przy użyciu Vinchin Backup & Recovery
Aby zapewnić skuteczną ochronę danych, możesz polegać na Vinchin Backup & Recovery, który pomógł wielu przedsiębiorstwom i organizacjom w zabezpieczeniu ich danych.
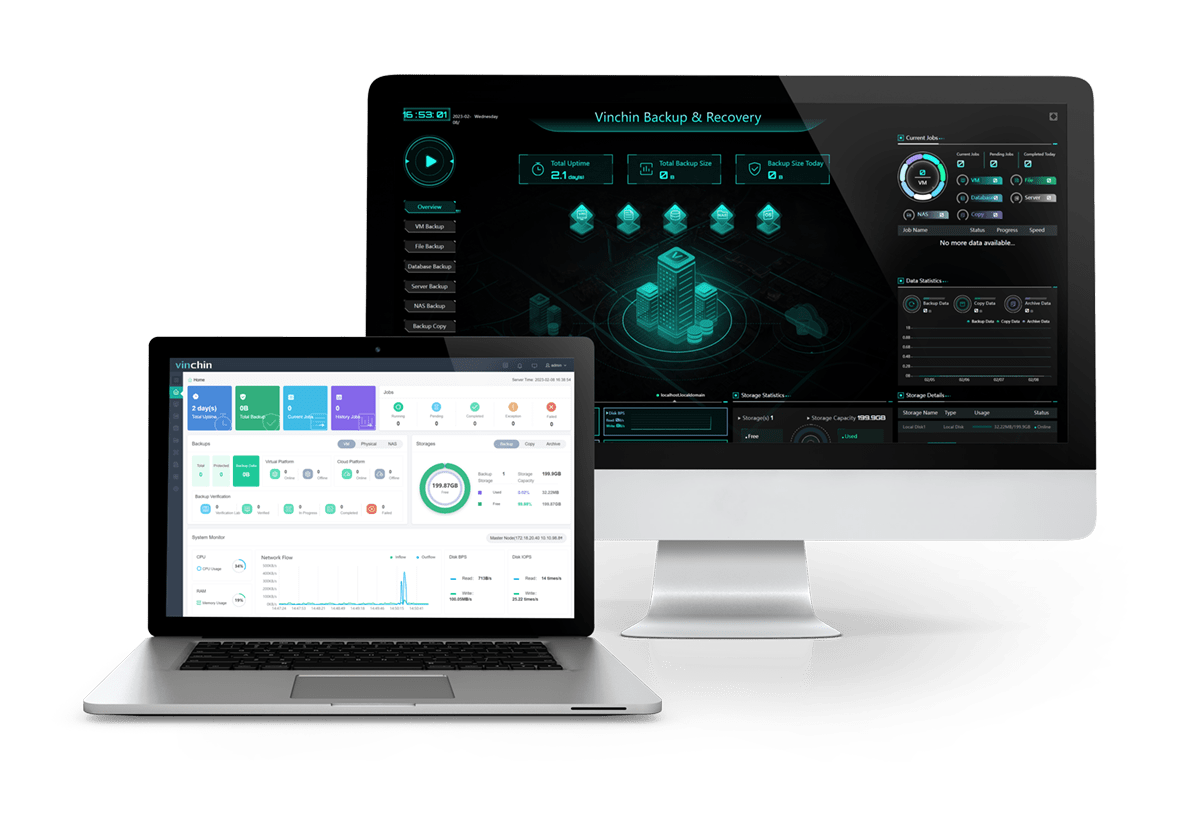
Vinchin Backup & Recovery jest profesjonalnym rozwiązaniem, które obsługuje tworzenie kopii zapasowych danych maszyn wirtualnych, takich jak VMware vSphere, Hyper-V, XenServer, XCP-ng, oVirt, RHV, OpenStack i innych, a także innych danych, takich jak bazy danych, NAS, serwer plików i inne.
Dane można bezpośrednio przesyłać między magazynem produkcyjnym a magazynem kopii zapasowej poprzez ścieżkę LAN-Free (sieć magazynowania FC, iSCSI, NFS) bez obciążania sieci produkcyjnej.
Ponadto Vinchin Backup & Recovery oferuje zestaw nowoczesnych funkcji umożliwiających automatyzację, przyspieszenie i odnowę ochrony maszyn wirtualnych i baz danych, aby pomóc Ci lepiej stawić czoła wyzwaniom wynikającym z przebiegłych zagrożeń bezpieczeństwa danych, które mogą doprowadzić do naruszenia RODO bez wyraźnych oznak.
Vinchin Backup & Recovery została wybrana przez tysiące firm i organizacji, a Ty również możesz zacząć korzystać z tego potężnego systemu dzięki 60-dniowej, w pełni funkcjonalnej wersji próbnej. Kliknij przycisk, aby pobrać pakiet instalacyjny.
Podsumowanie
Wraz z szybkim rozwojem sieci i technologii komputerowej, wyciek danych i problemy związane z ich zabezpieczeniem stają się coraz poważniejsze. Dlatego ochrona bezpieczeństwa i prywatności danych staje się problemem, z którym muszą zmierzyć się zarówno przedsiębiorstwa, jak i osoby prywatne.
Winchin Backup & Recovery to dobre rozwiązanie do ochrony danych w różnych środowiskach.