Les entreprises font face à des risques croissants tels que les cyberattaques et les catastrophes naturelles. La récupération de désastre sur le cloud hybride combine les systèmes sur site et les outils cloud pour protéger les données et les opérations. Elle équilibre contrôle, flexibilité et coûts.
Qu'est-ce que la reprise après sinistre dans le cloud hybride ?
La reprise après sinistre dans le cloud hybride utilise à la fois des systèmes locaux et des plateformes cloud pour protéger les données et maintenir le fonctionnement des applications en cas de perturbations. Elle copie continuellement les données hors site et automatiser les processus de basculement. Les charges de travail sensibles restent sur site pour des raisons de conformité, tandis que le cloud s'adapte à la demande et gère les pics de trafic soudains.
Un plan de reprise après sinistre dans le cloud hybride est une stratégie formalisée qui combine l'infrastructure sur site avec un ou plusieurs clouds publics ou privés pour répondre aux objectifs de temps de récupération définis (RTO) et aux objectifs de point de récupération (RPO). L'automatisation garantit un nombre minimal d'étapes manuelles, réduisant ainsi les erreurs humaines et accélérant la récupération.
Comparaison avec d'autres modèles
Le DR traditionnel repose uniquement sur un centre de données secondaire, souvent à un coût en capital élevé et avec une évolutivité plus lente.
Le DR uniquement basé sur le cloud offre une mise à l'échelle rapide, mais peut soulever des préoccupations en matière de conformité pour les charges de travail réglementées.
Le DR hybride combine les deux, offrant un contrôle sur les données sensibles et une élasticité coûteuse efficace.
Pourquoi l'DR dans le Cloud Hybride est-il important ?
Éliminer les points d'échec uniques
En répliquant les données vers une région cloud géographiquement séparée, vous vous protégez contre les catastrophes au niveau du site, telles que les coupures de courant ou les événements naturels. Le Multi-AZ au sein d'une région protège contre les pannes au niveau du rack ; l'hybride étend cela à la résilience au niveau des régions.
Équilibrage de charge et évolutivité
Les appliances locales conservent la maîtrise des données réglementées ; le bursting dans le cloud accommode les pics de trafic imprévisibles avec une capacité virtuellement infinie. Cette dualité évite surdimensionnement coûteux du matériel local tout en respectant les SLA de conformité.
Réduire les coûts de stockage
Mettez en œuvre des politiques de cycle de vie pour transférer les points de récupération plus anciens vers des classes d'objets à faible coût, réduisant ainsi les coûts de conservation à long terme jusqu'à 70 %. Utilisez l'étiquetage pour automatiser les transitions de classe en fonction de l'âge ou du type de sauvegarde.
Contre le ransomware
Les sauvegardes immuables dans des coffres WORM (write-once, read-many) empêchent le chiffrement par les logiciels malveillants. Les réplicas à isolation réseau et les stratégies de verrouillage de coffre garantissent l'intégrité des données, même si les sites principaux sont compromis.
Défis de la DR dans le Cloud Hybride
Latence du Réseau
Les longues distances entre les centres de données et les sites cloud ajoutent un retard aller-retour. Pour maintenir la réplication en quasi-temps réel, les organisations doivent :
Optimisez les liens en utilisant la priorisation du trafic et la compression pour réduire la latence effective.
Utilisez des circuits dédiés ou des connexions gérées pour éviter la surcharge du réseau public.
Mettre en œuvre un cache périphérique ou des accélérateurs de protocole qui réduisent les surcoûts de poignée de main et les retransmissions.
Coûts imprévisibles
Les fournisseurs de cloud annulent souvent les frais de transfert de données entrantes mais facturent ceux sortants, ainsi que l'utilisation des API et la récupération depuis les niveaux d'archives en profondeur. Pour contrôler les dépenses :
Prévoir la consommation en simulant les charges de pointe et en mesurant les modèles de sortie.
Définir des budgets et des alertes pour le stockage, le réseau et le calcul.
Archiver et hiérarchiser les sauvegardes inactives automatiquement - passer les instantanés plus anciens à des classes de stockage à moindre coût.
Failles de sécurité
Le mélange d'environnements sur site et dans le cloud peut entraîner des contrôles d'accès incohérents et une gestion des clés défaillante :
Unifier l'identité en intégrant les services de répertoire locaux avec l'IAM cloud, en appliquant les mêmes rôles de privilèges minimum partout.
<p Centralisez le chiffrement avec un processus de gestion de clés partagé qui fait pivoter les clés régulièrement et enregistre chaque utilisation.
Protéger les points d'extrémité en s'assurant que tous les agents de sauvegarde, passerelles et consoles exécutent les correctifs de sécurité à jour.
Compatibilité des Applications Héritées
Les systèmes plus anciens peuvent ne pas prendre en charge nativement les méthodes de réplication modernes :
Capture au niveau virtuel captures l'intégralité des disques et de l'état de la mémoire de la machine virtuelle pour éviter d'avoir besoin d'agents dans l'invité.
Les conteneurs ou shims vous permettent d'encapsuler des applications héritées dans un environnement d'exécution léger qui expose des API standard.
Les connecteurs personnalisés traduisent les flux de données propriétaires en flux génériques au niveau des blocs ou des fichiers.
Meilleures pratiques de reprise après sinistre dans le cloud hybride
Classer les données
Étiqueter correctement chaque charge de travail en fonction de son impact sur l'activité et des besoins en conformité :
Niveau 1 (Critique) : Réplication sans perte de données, synchronisée ou quasi-synchronisée.
Niveau 2 (Important) : Réplication asynchrone fréquente (RPO au niveau des minutes).
Niveau 3 (Non critique) : Sauvegarde périodique seulement.
Automatisez l’ajout de balises dès le début afin que les nouvelles machines virtuelles et bases de données héritent automatiquement des paramètres de reprise après sinistre corrects.
Testez régulièrement
Planifiez et automatissez des exercices de basculement trimestriels failover qui reflètent votre topologie de production :
Utilisez des comptes ou régions isolés « sandbox » ayant la même configuration de réseau, de calcul et de stockage.
Tests complets de bout en bout—from recovery-site provisioning à application validation—afin que vous détectiez les mauvaises configurations avant les incidents réels.
Automatiser complètement
Transformez chaque étape manuelle de DR en code et en workflows pilotés par des événements :
Les modèles d'Infrastructure as Code mettent en place des environnements DR à la demande.
Les runbooks d'orchestration déclenchent automatiquement des séquences de récupération lorsqu'un site principal est hors ligne.
Les hooks d'événement lancent les vérifications de dépendances, les contrôles de santé et les notifications sans intervention humaine.
Sauvegardes Sécurisées
Protégez les données de sauvegarde tant au repos qu'en transit :
Le chiffrement à clé fractionnée garde une moitié de chaque clé sur site et l'autre moitié dans un coffre-fort cloud sécurisé.
La rétention immuable empêche la suppression ou la modification des instantanés stockés pendant une période définie.
Les journaux d'audit captent chaque accès et chaque opération, alimentant votre SIEM pour une surveillance continue.
Surveiller les performances
Mesurer continuellement l'état de la réplication et l'utilisation des ressources :
Les métriques de retard indiquent à quel point les réplicas secondaires sont en retard par rapport à la source.
Les traceurs d'E/S et de bande passante mettent en évidence les goulets d'étranglement avant qu'ils n'atteignent les seuils RPO.
Les alertes automatisées et les workflows de récupération automatique peuvent redémarrer les tâches en retard, réallouer le débit, ou activer des tampons temporaires lorsque les seuils sont déclenchés.
Solution de récupération d'urgence hybride Vinchin
En s'appuyant sur les meilleures pratiques ci-dessus, la solution de récupération d'urgence hybride de Vinchin offre un ensemble complet de fonctionnalités pour sécuriser vos environnements virtuels et maintenir le bon fonctionnement des opérations.
Vinchin propose la récupération instantanée des machines virtuelles instant recovery, vous permettant de démarrer toute machine virtuelle directement à partir d'une sauvegarde en aussi peu de 15 secondes. Vous pouvez également archiver les sauvegardes dans des niveaux de stockage cloud pour une conservation à long terme via des stratégies GFS. Vinchin prend également en charge les sauvegardes sur bande, fonctionnant avec des bibliothèques de bandes physiques et virtuelles pour un archivage hors ligne. La réplication de sauvegarde distante synchronise automatiquement les copies de coffre vers des sites distants.
Pour un RPO proche de zéro, Vinchin offre une protection continue des données (CDP) afin de capturer chaque transaction en temps réel. Vous pouvez appliquer la rétention GFS pour répondre aux exigences de conformité concernant les sauvegardes hebdomadaires, mensuelles et annuelles. La plateforme effectue la vérification des données de sauvegarde des machines virtuelles grâce au test de démarrage dans un laboratoire isolé pour garantir la récupérabilité. Enfin, la restauration granulaire vous permet de récupérer des fichiers ou dossiers individuels sans avoir à restaurer toute la machine virtuelle.
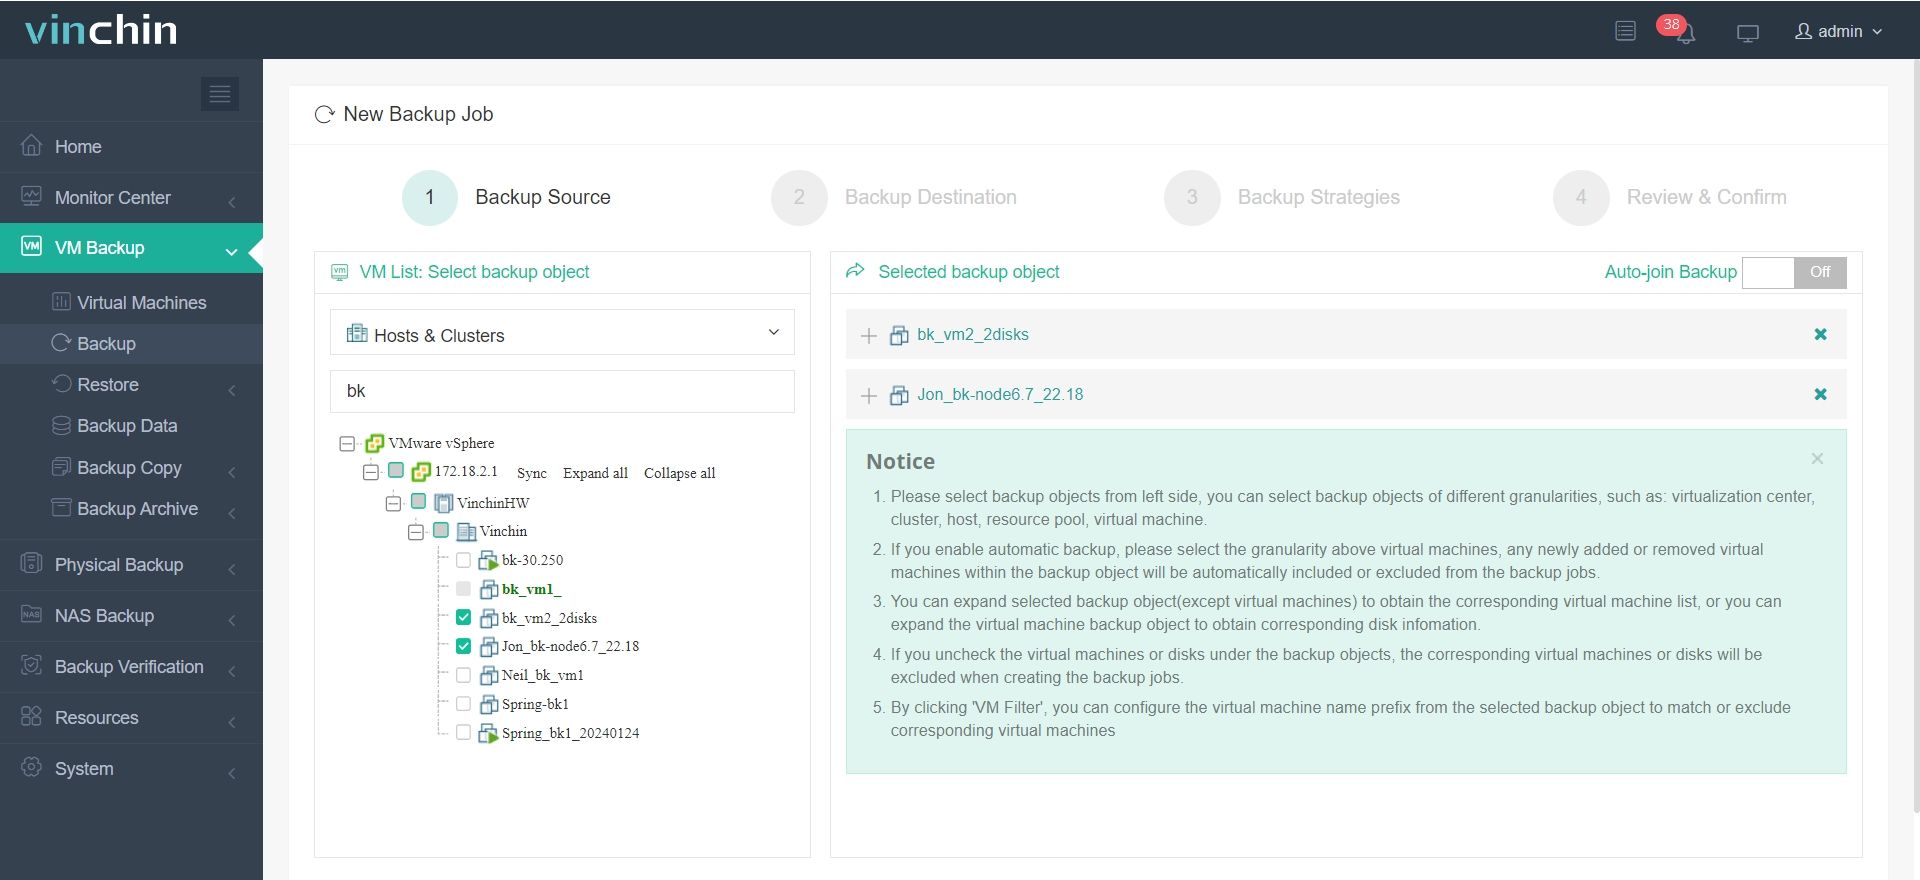
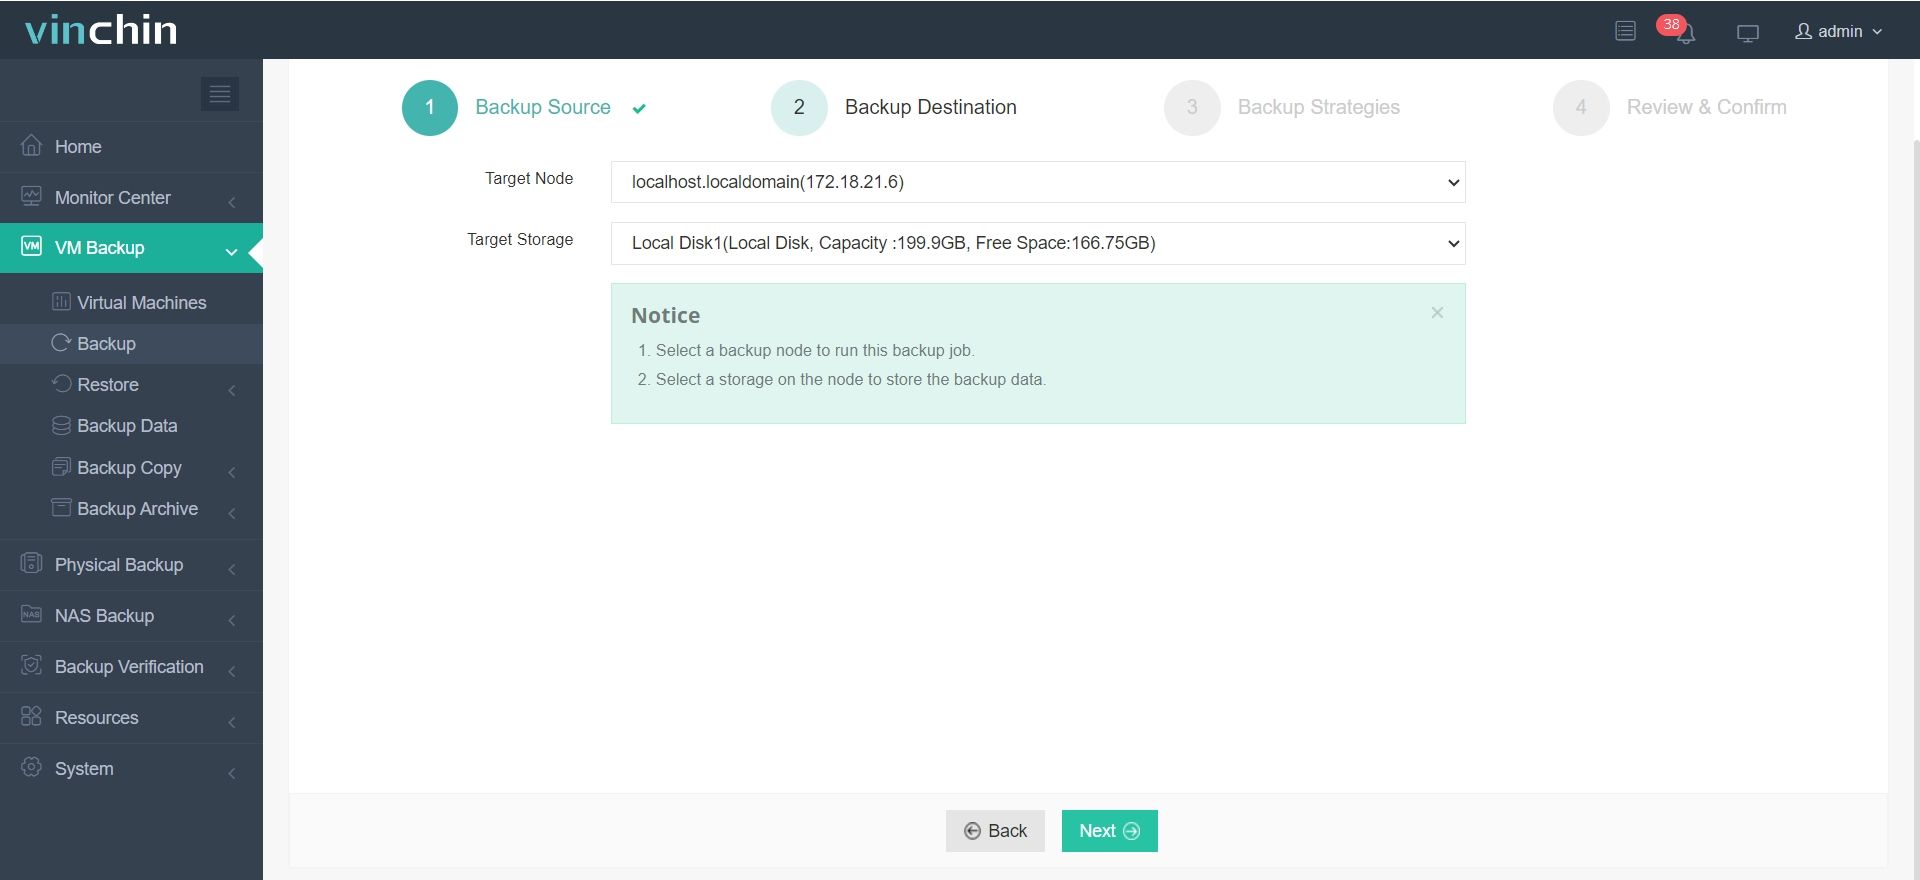
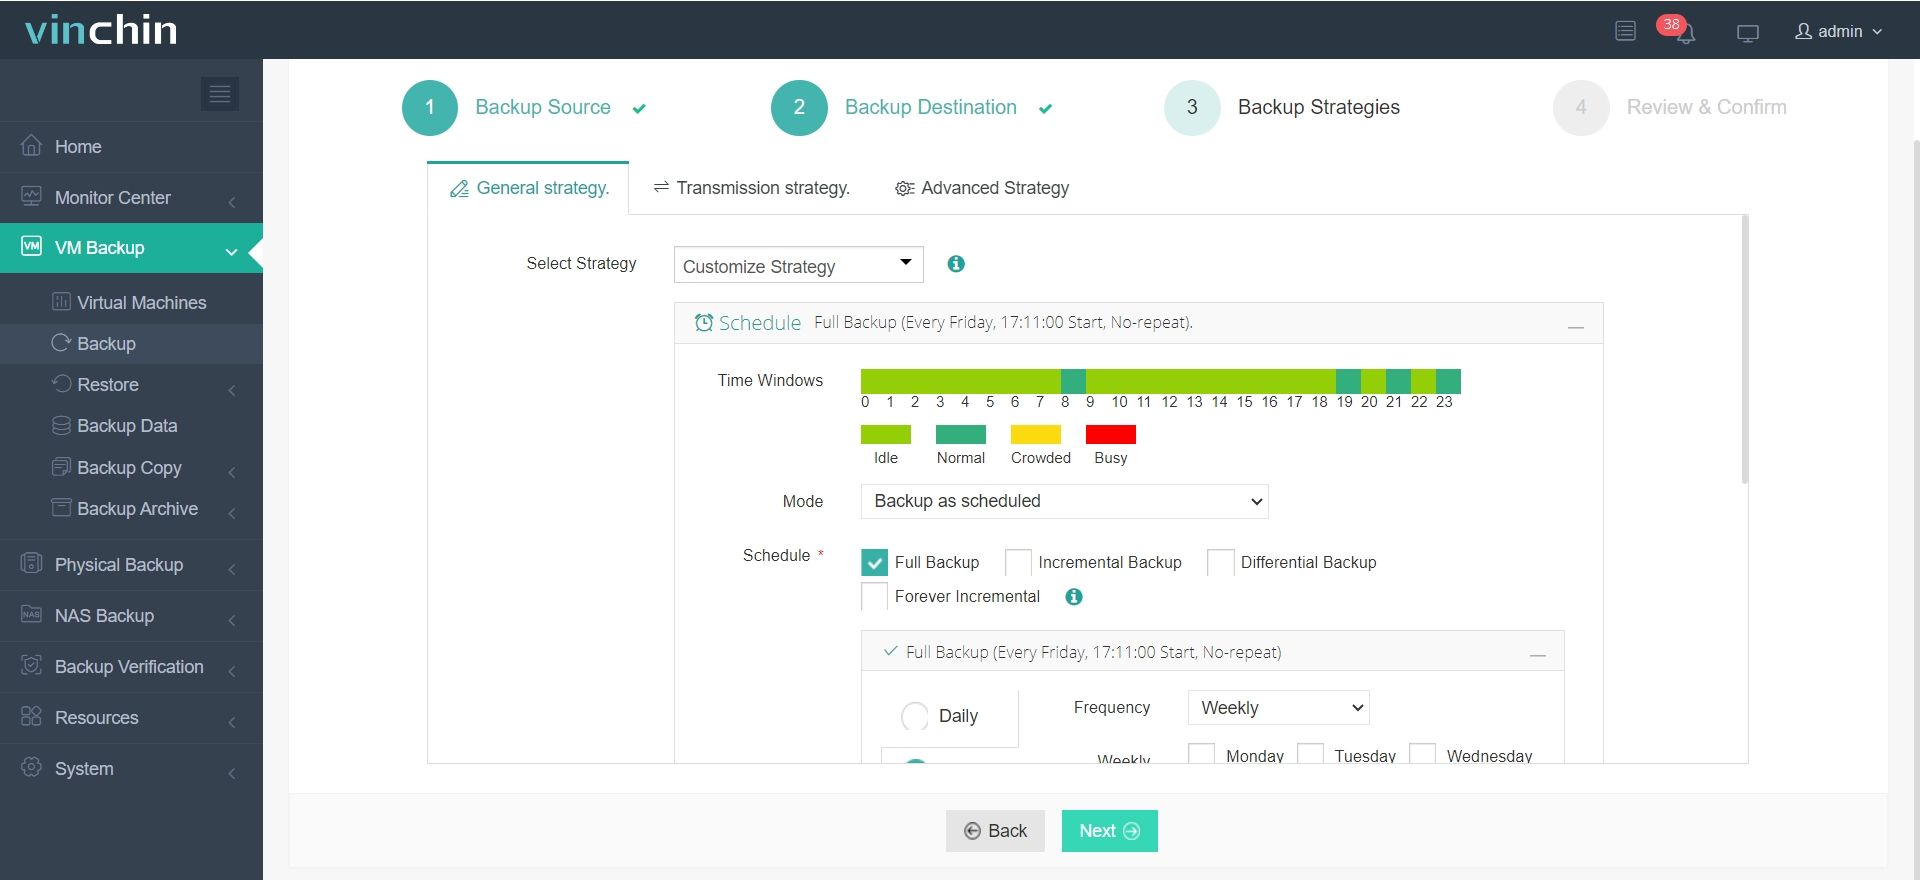
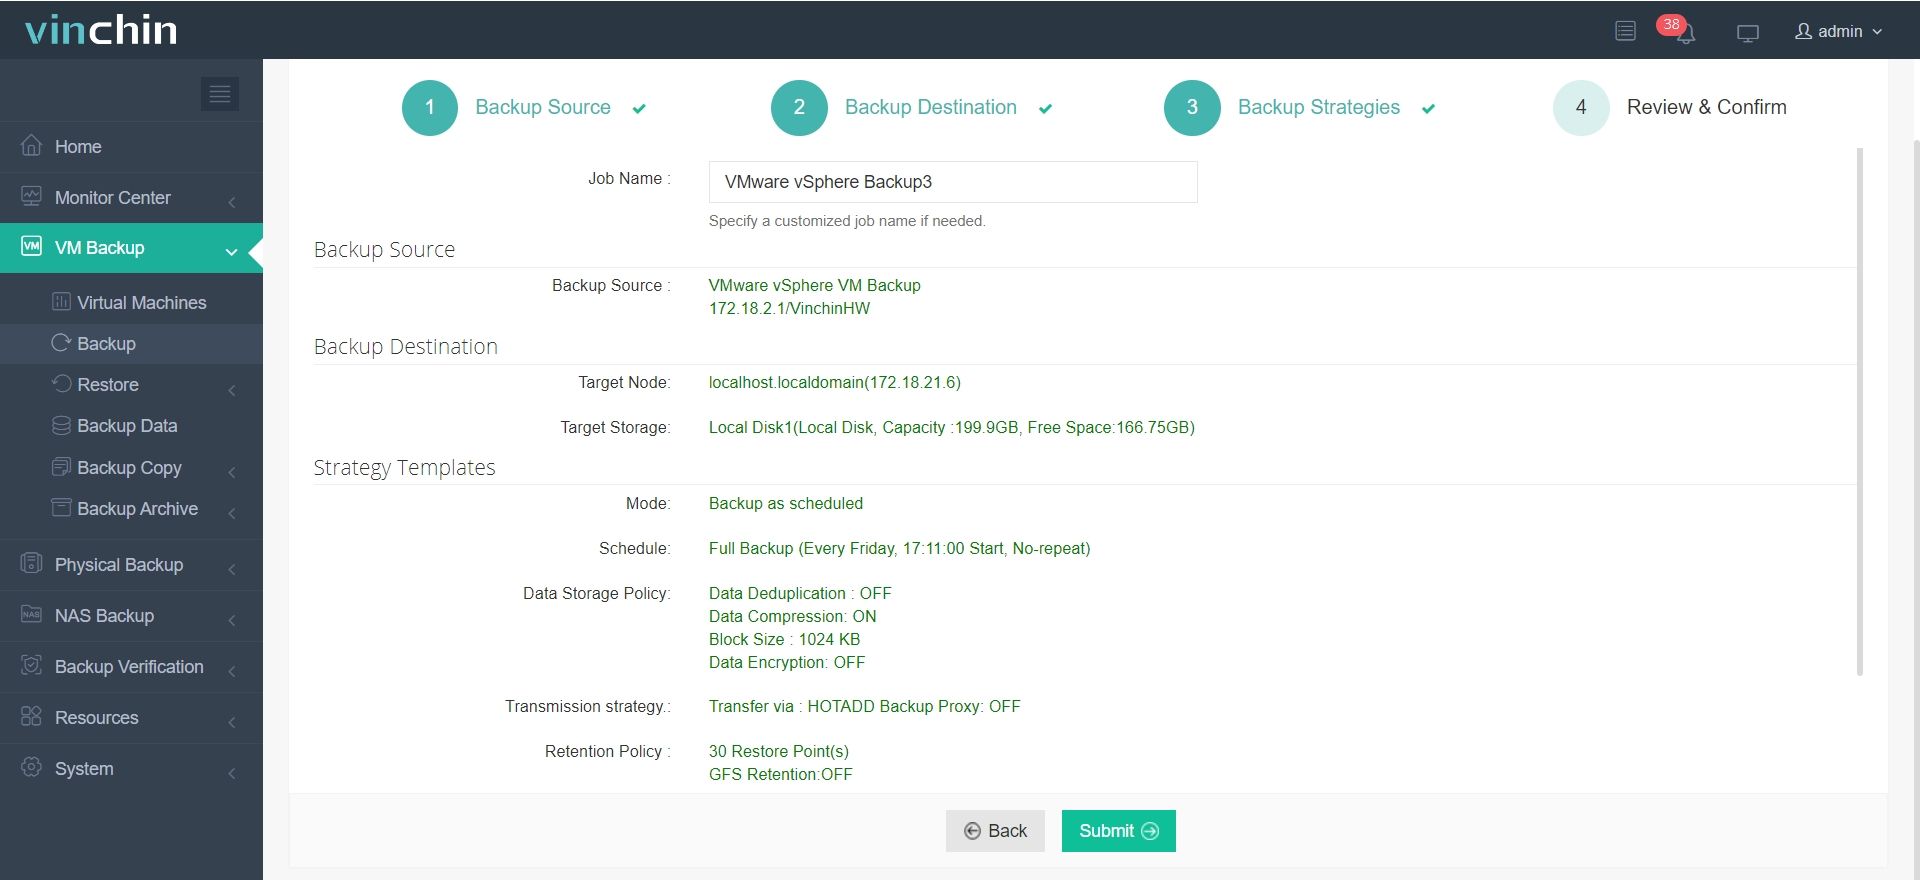
Avec la console web intuitive de Vinchin, le déploiement d'une solution de reprise après sinistre dans un cloud hybride se fait en quatre étapes seulement :
1. Sélectionnez la machine virtuelle que vous souhaitez sauvegarder
2. Choisissez le stockage de sauvegarde
3. Définissez la stratégie de sauvegarde
4. Soumettez le travail
Rejoignez plus de 30000 entreprises mondiales qui font confiance à la solution de premier plan de Vinchin. Démarrer votre essai gratuit de 60 jours avec toutes les fonctionnalités aujourd'hui et voyez comme il est facile de sécuriser des charges de travail critiques. Cliquez sur TELECHARGER pour déployer en quelques minutes.
FAQ sur la reprise après sinistre dans le cloud hybride
Q1 : Qu'est-ce qui rend la reprise après sinistre dans le cloud hybride unique ?
A : Cela combine le contrôle sur site avec la rapidité du cloud, en évitant l'enfermement chez un fournisseur.
Q2 : Quel est le plus grand défi technique du DR cloud hybride ?
A : Maintenir les retards de réseau en dessous de 15 ms pour les sauvegardes en temps réel.
Q3 : Comment réduire les coûts de DR dans un cloud hybride ?
A : Stockez les anciennes sauvegardes dans un stockage cloud économique (Glacier) et synchronisez uniquement les données critiques.
Conclusion
La récupération après sinistre dans le cloud hybride offre une voie pratique pour les entreprises. Elle garde les données sensibles en sécurité localement tout en utilisant la puissance du cloud en cas d'urgence. En automatisant les processus, en testant les plans et en gérant les coûts, les organisations peuvent affronter les perturbations avec confiance.
Pour mieux protéger votre charge de travail, téléchargez simplement Vinchin pour protéger vos données de toutes les manières. N'oubliez pas d'essayer la version d'essai gratuite.