ด้วยความนิยมของการประมวลผลแบบคลาวด์ OpenStack ซึ่งเป็นแพลตฟอร์มคลาวด์แบบโอเพ่นซอร์ส ได้ถูกนำมาใช้อย่างแพร่หลาย โดยให้ความสามารถในการจัดการทรัพยากรเสมือนที่ทรงพลังสำหรับองค์กรและนักพัฒนา ทำให้การติดตั้งและจัดการสภาพแวดล้อมคลาวด์มีประสิทธิภาพมากขึ้น อย่างไรก็ตาม ในทางปฏิบัติผู้ใช้มักประสบปัญหาและข้อผิดพลาดเกี่ยวกับการจัดการอินสแตนซ์ ซึ่งอาจส่งผลกระทบต่อความเสถียรของบริการและสร้างความท้าทายในการบำรุงรักษาได้ ดังนั้น การเข้าใจและการแก้ไขข้อผิดพลาดของ OpenStack อินสแตนซ์จึงเป็นสิ่งสำคัญเพื่อให้แน่ใจว่าสภาพแวดล้อมคลาวด์ทำงานได้อย่างถูกต้อง ในโพสต์นี้ เราจะเจาะลึกถึงข้อผิดพลาดทั่วไปเหล่านี้และแนวทางการแก้ไข
ประเภทและสาเหตุของข้อผิดพลาดอินสแตนซ์ OpenStack มีอะไรบ้าง?
ก่อนที่คุณจะเริ่มจัดการกับข้อผิดพลาดของอินสแตนซ์ OpenStack คุณจำเป็นต้องระบุประเภทของข้อผิดพลาดที่อาจเกิดขึ้นและสาเหตุที่อยู่เบื้องหลังเสียก่อน ข้อผิดพลาดของอินสแตนซ์ OpenStack ที่พบบ่อย ได้แก่ ข้อผิดพลาดด้านการเชื่อมต่อเครือข่าย ข้อผิดพลาดการมิเรอร์ (mirroring errors) ข้อจำกัดด้านโควตา และข้อผิดพลาดเกี่ยวกับสถานะของอินสแตนซ์ แต่ละประเภทของข้อผิดพลาดอาจมีสาเหตุพื้นฐานที่แตกต่างกัน การระบุประเภทของข้อผิดพลาดอย่างถูกต้องจึงเป็นขั้นตอนแรกในการดำเนินการแก้ไขปัญหาอย่างมีประสิทธิภาพ
ตรวจสอบสถานะอินสแตนซ์
ขั้นตอนแรกในการจัดการกับข้อผิดพลาดของอินสแตนซ์ใน OpenStack คือการตรวจสอบสถานะปัจจุบันของอินสแตนซ์ เพื่อช่วยระบุสาเหตุที่แท้จริงของปัญหา ข้อมูลสถานะของอินสแตนซ์สามารถรับได้โดยใช้รหัส Python ต่อไปนี้:
import openstack

def get_instance_status(instance_id):
    conn = openstack.connect(cloud='mycloud')
    instance = conn.compute.find_server(instance_id)
return instance.status
การจัดการตามประเภทของข้อผิดพลาด
ขึ้นอยู่กับสถานะของอินสแตนซ์และประเภทของข้อผิดพลาด ระบบจะดำเนินการตามขั้นตอนที่เหมาะสม
ข้อผิดพลาดการเชื่อมต่อเครือข่าย
หากอินสแตนซ์ไม่สามารถเชื่อมต่อกับเครือข่ายหรือการเชื่อมต่อเครือข่ายผิดปกติ อาจเกิดจากกฎกลุ่มรักษาความปลอดภัยหรือเส้นทางที่กำหนดค่าผิด คุณสามารถใช้รหัสด้านล่างเพื่อตรวจสอบและแก้ไขกฎของกลุ่มรักษาความปลอดภัย:
def check_security_group(instance_id):
    conn = openstack.connect(cloud='mycloud')
    instance = conn.compute.find_server(instance_id)
    security_groups = conn.network.get_server_security_groups(instance)
    return security_groups

def update_security_group_rule(security_group_id, protocol, port):
    conn = openstack.connect(cloud='mycloud')
    rule = conn.network.create_security_group_rule(
        security_group_id=security_group_id,
        protocol=protocol,
        port_range_min=port,
        port_range_max=port
    )
return rule
ข้อผิดพลาดของภาพสะท้อน
หากอินสแตนซ์พบข้อผิดพลาดของภาพสะท้อนระหว่างการเริ่มต้น อาจเกิดจากภาพสะท้อนที่เสียหายหรือไม่สมบูรณ์ สามารถใช้รหัสด้านล่างเพื่อดูและแก้ไขภาพสะท้อนของอินสแตนซ์ได้:
def get_instance_image(instance_id):
    conn = openstack.connect(cloud='mycloud')
    instance = conn.compute.find_server(instance_id)
    return instance.image

def update_instance_image(instance_id, new_image_id):
    conn = openstack.connect(cloud='mycloud')
conn.compute.rebuild_server(instance_id, new_image_id)
ขีดจำกัดโควตา
หากอินสแตนซ์เริ่มต้นไม่สำเร็จและแสดงข้อผิดพลาดเกี่ยวกับขีดจำกัดโควตา อาจเป็นเพราะโควตาทรัพยากรของโปรเจกต์ปัจจุบันถูกใช้หมดแล้ว คุณสามารถใช้รหัสต่อไปนี้เพื่อดูและปรับเปลี่ยนขีดจำกัดโควตาของโปรเจกต์ได้:
def get_project_quota(project_id):
    conn = openstack.connect(cloud='mycloud')
    quota = conn.compute.get_quota(project_id)
    return quota

def update_project_quota(project_id, new_quota):
    conn = openstack.connect(cloud='mycloud')
conn.compute.update_quota(project_id, **new_quota)
ข้อผิดพลาดของสถานะอินสแตนซ์
หากสถานะของอินสแตนซ์ผิดปกติ เช่น เริ่มต้นไม่สำเร็จ หยุดไม่สำเร็จ เป็นต้น อาจเกิดจากทรัพยากรไม่เพียงพอหรือปัญหาอื่นๆ คุณสามารถใช้รหัสด้านล่างเพื่อดูและแก้ไขสถานะของอินสแตนซ์ได้:
def start_instance(instance_id):
    conn = openstack.connect(cloud='mycloud')
    conn.compute.start_server(instance_id)

def stop_instance(instance_id):
    conn = openstack.connect(cloud='mycloud')
conn.compute.stop_server(instance_id)
การจัดการข้อผิดพลาดและการบันทึก
เมื่อจัดการกับข้อผิดพลาดของอินสแตนซ์ OpenStack คุณจำเป็นต้องล็อกข้อความแสดงข้อผิดพลาดและดำเนินการจัดการข้อผิดพลาดอย่างทันท่วงที เพื่ออำนวยความสะดวกในการตรวจสอบปัญหาและการเพิ่มประสิทธิภาพในขั้นตอนถัดไป โค้ดต่อไปนี้สามารถใช้สำหรับบันทึกบันทึกรายงานข้อผิดพลาดได้:
import logging

def log_error(error_message):
logging.error(error_message)
การปกป้องอินสแตนซ์ OpenStack ของคุณด้วย Vinchin VM Backup
เพื่อให้มั่นใจในความพร้อมใช้งานสูงและความปลอดภัยของข้อมูลในสภาพแวดล้อมคลาวด์ของคุณ คุณจำเป็นต้องมีโซลูชันสำรองข้อมูลที่เชื่อถือได้เพื่อปกป้องข้อมูลเครื่องเสมือนของคุณ รวมถึงการจัดการข้อผิดพลาดของอินสแตนซ์ใน OpenStack อย่างมีประสิทธิภาพ ซึ่ง Vinchin Backup & Recovery สามารถเป็นตัวเลือกที่เหมาะสมที่สุดสำหรับคุณได้
Vinchin Backup & Recovery มีฟีเจอร์การสำรองข้อมูลและการกู้คืนเครื่องเสมือนที่ทรงพลัง ออกแบบมาเพื่อสภาพแวดล้อมการประมวลผลแบบคลาวด์ ไม่ว่าจะเป็นข้อมูลอินสแตนซ์บนแพลตฟอร์มคลาวด์ OpenStack หรือข้อมูลสำคัญทางธุรกิจบนแพลตฟอร์มเสมือนอื่น ๆ (VMware, Proxmox, Hyper-V, XenServer, XCP-ng, oVirt, RHV และอีกมากกว่า 10 แพลตฟอร์ม) Vinchin ก็มอบโซลูชันการป้องกันข้อมูลครบวงจรให้คุณ
Vinchin ให้การป้องกันข้อมูลอย่างครอบคลุมสำหรับ OpenStack VMs ผ่านการสำรองข้อมูลอัตโนมัติ เทคโนโลยีการบีบอัดข้อมูลและการลบข้อมูลซ้ำอย่างชาญฉลาด ตัวเลือกการกู้คืนที่ยืดหยุ่น และการกู้คืนจากภัยพิบัตินอกสถานที่ ไม่เพียงแต่ช่วยให้มั่นใจได้ว่าข้อมูลจะได้รับการปกป้องอยู่เสมอ แต่ยังลดต้นทุนการจัดเก็บข้อมูลอย่างมาก กู้คืนการทำงานได้อย่างรวดเร็ว และรับประกันว่าสภาพแวดล้อมคลาวด์ของคุณจะยังคงมีความมั่นคงและเชื่อถือได้แม้เผชิญกับความท้าทายต่างๆ
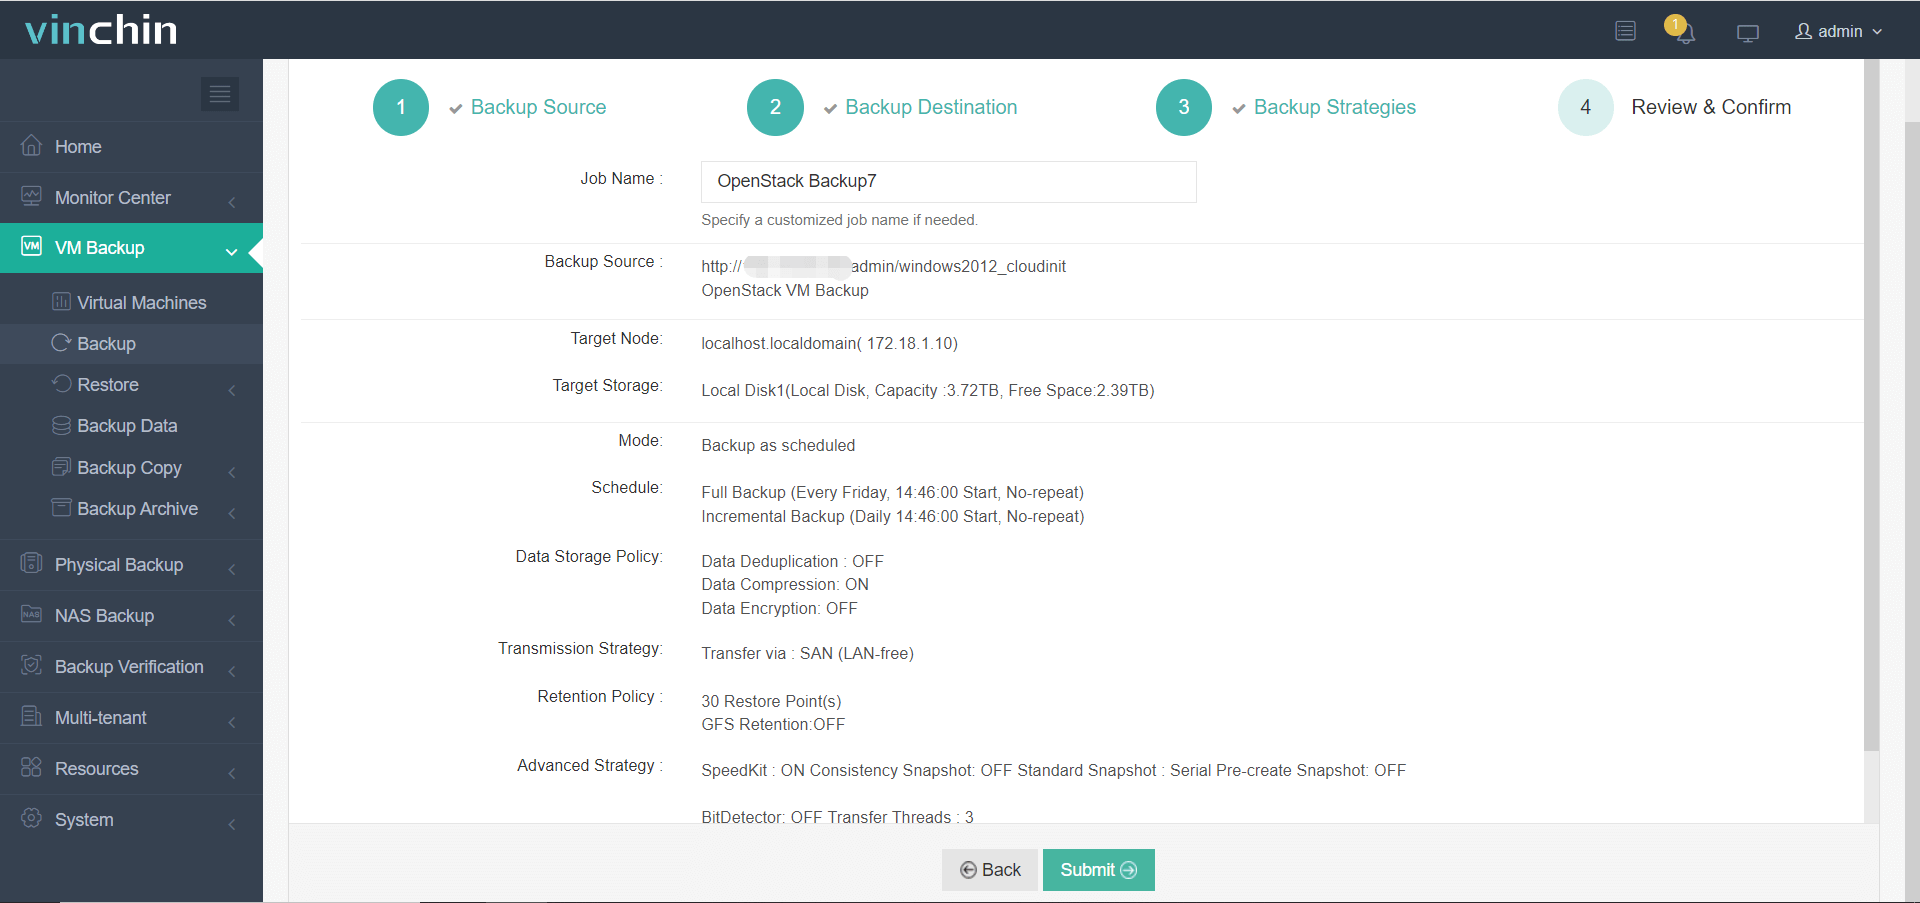
การดำเนินการของ Vinchin Backup & Recovery นั้นง่ายมาก เพียงไม่กี่ขั้นตอนง่ายๆ เท่านั้น
1. เลือกเครื่องเสมือนบนโฮสต์เพียงอย่างเดียว
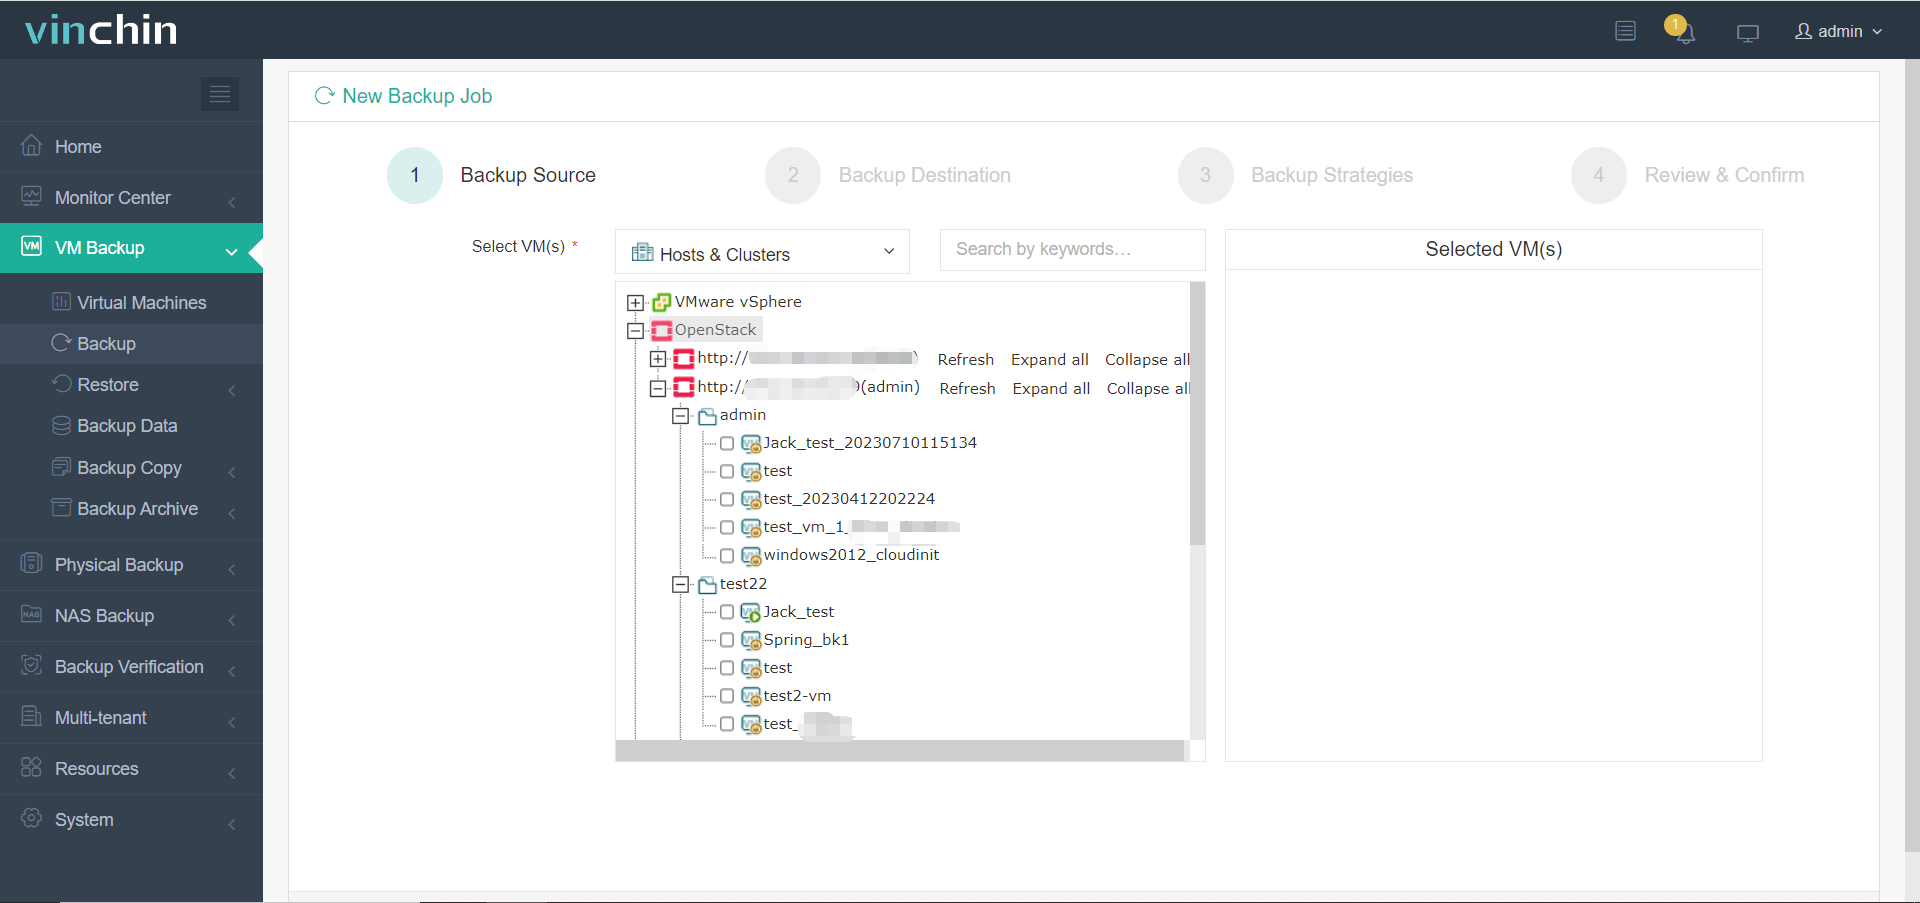
2. จากนั้นเลือกตำแหน่งสำรองข้อมูล
3. เลือกกลยุทธ์
4. ส่งงานในที่สุด
Vinchin ขอเสนอการทดลองใช้งานฟรี 60 วัน เพื่อให้ผู้ใช้ได้สัมผัสกับประสิทธิภาพของคุณสมบัติต่างๆ ในสภาพแวดล้อมจริง หากอยากรู้ข้อมูลเพิ่มเติม กรุณาติดต่อ Vinchin โดยตรง หรือปรึกษาหนึ่งในพันธมิตรท้องถิ่นของเรา
คำถามที่พบบ่อยเกี่ยวกับข้อผิดพลาดของอินสแตนซ์ใน OpenStack
Q1: ฉันจะป้องกันข้อผิดพลาดของอินสแตนซ์ในอนาคตได้อย่างไร?
A1: ตรวจสอบให้แน่ใจว่าการตั้งค่าทั้งหมดถูกต้อง และโหนดประมวลผลมีทรัพยากรเพียงพอ ควรตรวจสอบสภาพแวดล้อม OpenStack เป็นประจำ อัปเดตระบบอย่างสม่ำเสมอ และใช้ภาพที่เสถียรและผ่านการทดสอบแล้วสำหรับอินสแตนซ์
Q2: หากอินสแตนซ์ไม่สามารถหยุดทำงานได้ ควรดำเนินการอย่างไร?
A2: หากอินสแตนซ์ไม่สามารถหยุดทำงานได้ อาจเกิดจากปัญหาของไฮเปอร์ไวเซอร์หรือการเชื่อมต่อเครือข่าย พยายามลบอินสแตนซ์แบบบังคับโดยใช้คำสั่ง `nova delete --force <instance_id>` หากไม่สำเร็จ คุณอาจต้องล้างทรัพยากรบนไฮเปอร์ไวเซอร์ด้วยตนเอง
สรุป
การเข้าใจและแก้ไขข้อผิดพลาดของอินสแตนซ์ OpenStack เป็นสิ่งสำคัญต่อการรักษาระบบคลาวด์ให้มีเสถียรภาพ การดำเนินงานอย่างมีประสิทธิภาพ และการปกป้องข้อมูลด้วยโซลูชันการสำรองข้อมูลที่เชื่อถือได้อย่าง Vinchin Backup & Recovery