ความพร้อมใช้งานสูง (HA) และการกู้คืนระบบหลังภัยพิบัติ (DR) เป็นสององค์ประกอบที่สำคัญยิ่งของการบริหารจัดการระบบไอที ซึ่งมีเป้าหมายเพื่อให้มั่นใจว่าระบบจะทำงานอย่างต่อเนื่องและช่วงเวลาที่ระบบหยุดทำงานมีน้อยที่สุด แม้ว่าบางครั้งอาจใช้คำทั้งสองนี้แทนกันได้ แต่ทั้งสองคำนี้หมายถึงกลยุทธ์และวิธีแก้ไขปัญหาที่แตกต่างกัน
ความพร้อมใช้งานสูงคืออะไร?
ความพร้อมใช้งานสูงหมายถึงความสามารถในการเข้าถึงแอปพลิเคชันต่อไปได้ แม้ว่าจะเกิดข้อผิดพลาดขององค์ประกอบใดๆ หนึ่งในระบบภายใน โดยไม่ขึ้นกับว่าข้อผิดพลาดนั้นจะเกิดจากกระบวนการทำงานทางธุรกิจ โครงสร้างพื้นฐานทางกายภาพ หรือซอฟต์แวร์/ฮาร์ดแวร์ด้านไอที สภาพแวดล้อมที่ดีที่สุดสำหรับความพร้อมใช้งานคือเมื่อเครื่องใดเครื่องหนึ่งของคุณหยุดทำงาน ผู้ใช้งานบริการของคุณจะไม่รู้สึกถึงผลกระทบใดๆ เลย
เมื่อเครื่องของคุณล่ม บริการที่ทำงานอยู่บนเครื่องนั้นจะต้องเปลี่ยนโหมดการทำงานอย่างแน่นอน ต้นทุนของการสลับโหมดวัดได้จากสองมิติ ได้แก่ RTO (ระยะเวลาที่ใช้ในการกู้คืนข้อมูล) และ RPO (จุดที่ย้อนกลับไปกู้คืนข้อมูล)
RTO คือระยะเวลาที่ใช้ในการกู้คืนบริการ โดยกรณีที่ดีที่สุดคือ 0 หมายความว่าบริการถูกกู้คืนทันที ส่วนกรณีที่แย่ที่สุดคือ อินฟินิตี้ หมายความว่าบริการไม่สามารถกู้คืนได้เลย RPO คือช่วงเวลาของข้อมูลที่จะถูกกู้คืนในระหว่างการสลับไปใช้ระบบที่สำรองไว้ โดยค่า 0 หมายถึงใช้ข้อมูลที่ซิงโครไนซ์แล้ว ค่ามากกว่า 0 หมายถึงมีข้อมูลสูญหาย เช่น "RPO = 1 วัน" หมายถึงใช้ข้อมูลเมื่อหนึ่งวันก่อนสำหรับการกู้คืน ดังนั้นข้อมูลใดๆ ที่สร้างขึ้นภายในวันนั้นจะสูญหายไป ดังนั้นผลลัพธ์การกู้คืนที่ดีที่สุดคือ RTO = RPO = 0 แต่นี่เป็นสถานการณ์ที่เพ้อฝันเกินไป หรือต้นทุนในการทำให้เกิดขึ้นจริงมีสูงเกินไป
สำหรับ HA มักใช้พื้นที่จัดเก็บร่วม ซึ่งช่วยให้สามารถทำ RPO = 0 ได้ ในขณะเดียวกัน มักใช้โหมด HA แบบ Active/Active เพื่อให้ได้ค่า RTO ใกล้เคียงศูนย์ หากใช้โหมด HA แบบ Active/Passive แล้ว จำเป็นต้องลดค่า RTO ให้น้อยที่สุด
ประเภทของระบบความพร้อมใช้งานสูง
ระบบความพร้อมใช้งานสูงต้องใช้เซิร์ฟเวอร์สำรองเพื่อสร้างคลัสเตอร์ในการดำเนินงาน รวมถึงแอปพลิเคชันและบริการ การมีระบบที่ซ้ำซ้อนนี้ยังทำให้ระบบความพร้อมใช้งานสูงสามารถแบ่งออกเป็นสองประเภทได้:
HA แบบแอคทีฟ/แพสซีฟ: ในระบบนี้ บริการจะถูกนำเสนอเฉพาะในโหนดที่ทำงานอยู่เท่านั้น เมื่อโหนดที่ทำงานล้มเหลว บริการในโหนดสำรองจะถูกเริ่มต้นขึ้นเพื่อแทนที่บริการที่ให้โดยโหนดหลัก
Active/Active HA: ในการกำหนดค่านี้ ระบบจะรันเวิร์กโหลดเดียวกันบนเซิร์ฟเวอร์ทั้งหมดภายในคลัสเตอร์ โดยยกตัวอย่างเช่น ฐานข้อมูล การอัปเดตไปยังอินสแตนซ์หนึ่งจะถูกซิงค์ให้ตรงกับอินสแตนซ์ทั้งหมด การกำหนดค่านี้มักใช้ซอฟต์แวร์การกระจายภาระงานเพื่อให้บริการผ่านที่อยู่ไอพีเสมือน
HA จัดประเภทบริการเป็นสองประเภท:
บริการแบบ Stateful: คำขอที่ตามมาต่อบริการขึ้นอยู่กับคำขอที่ผ่านมา
บริการที่ไม่มีสถานะ: การร้องขอไปยังบริการแต่ละรายการเป็นอิสระจากกันและแยกจากกันอย่างสมบูรณ์
การกู้คืนระบบหลังภัยพิบัติคืออะไร?
ภัยพิบัติหมายถึงเหตุการณ์ที่เกิดขึ้นอย่างฉับพลันอันเนื่องมาจากสาเหตุจากมนุษย์หรือธรรมชาติ ซึ่งส่งผลให้ระบบสารสนเทศภายในศูนย์ข้อมูลเกิดความผิดปกติรุนแรงหรือหยุดทำงาน ส่งผลให้ฟังก์ชันทางธุรกิจที่ใช้ระบบสารสนเทศรองรับไม่สามารถดำเนินการได้ตามปกติ หรือทำให้ระดับการให้บริการลดลงจนอยู่ในสถานะที่ยอมรับไม่ได้เป็นระยะเวลาหนึ่ง โดยทั่วไปจำเป็นต้องเปลี่ยนไปดำเนินการที่ไซต์อื่นแทน
การกู้คืนระบบหลังภัยพิบัติ คือ ความสามารถในการคืนข้อมูล แอปพลิเคชัน หรือศักยภาพทางธุรกิจที่ศูนย์ข้อมูลแห่งอื่น เมื่อเกิดภัยพิบัติจนทำให้ศูนย์ปฏิบัติการหลักไม่สามารถใช้งานได้
ความทนทานต่อภัยพิบัติ หมายถึง ไซต์สำรองที่ผู้ใช้จัดตั้งขึ้นเพิ่มเติมจากไซต์ผลิต เมื่อเกิดภัยพิบัติและไซต์ผลิตได้รับความเสียหาย ไซต์สำรองสามารถเข้ามาดำเนินการทางธุรกิจแทนได้ เพื่อให้มั่นใจว่าธุรกิจจะดำเนินต่อไปได้ เพื่อให้มีความสามารถในการใช้งานที่สูงขึ้น ผู้ใช้จำนวนมากจึงจัดตั้งไซต์สำรองหลายแห่ง
มีตัวชี้วัดหลักสองประการสำหรับการวัดประสิทธิภาพของระบบกู้คืนภัยพิบัติ ได้แก่ RPO และ RTO โดย RPO แสดงถึงปริมาณข้อมูลที่ยอมรับได้ว่าจะสูญหายเมื่อเกิดภัยพิบัติ ขณะที่ RTO แสดงถึงระยะเวลาที่ใช้ในการกู้คืนระบบ ยิ่งค่า RPO และ RTO เล็กเท่าไร ความพร้อมใช้งานของระบบก็จะยิ่งสูงขึ้นตามไปด้วย อย่างเป็นธรรมชาติ ผู้ใช้งานจำเป็นต้องลงทุนมากขึ้น
ความพร้อมใช้งานสูงเทียบกับการกู้คืนจากภัยพิบัติ
ความสัมพันธ์ระหว่าง HA และ DR มีความเกี่ยวข้องและเสริมซึ่งกันและกัน แต่ก็มีความแตกต่างที่สำคัญ:
HA โดยทั่วไปหมายถึงระบบความพร้อมใช้งานสูงในพื้นที่ ซึ่งทำให้มั่นใจได้ว่าแอปพลิเคชันจะยังคงทำงานต่อไปโดยไม่มีการหยุดชะงักบนเซิร์ฟเวอร์หลายเครื่อง ในกรณีที่เกิดข้อผิดพลาดของเซิร์ฟเวอร์ใดๆ เครื่องหนึ่ง แอปพลิเคชันและระบบควรสามารถสลับไปยังเซิร์ฟเวอร์อื่นได้อย่างรวดเร็วเพื่อดำเนินการต่อ ซึ่งเกี่ยวข้องกับการจัดกลุ่มระบบในพื้นที่และการสลับการทำงานแบบร้อน HA มักใช้ที่จัดเก็บข้อมูลร่วมกัน ดังนั้นโดยทั่วไปจะไม่มีการสูญเสียข้อมูล (RPO = 0) และเน้นเป็นพิเศษที่ RTO
DR หมายถึง ระบบความพร้อมใช้งานสูงที่กระจายอยู่ตามภูมิศาสตร์ (ไม่ว่าจะอยู่ในเมืองเดียวกันหรือต่างสถานที่กัน) และแสดงถึงความสามารถในการกู้คืนข้อมูล แอปพลิเคชัน และการดำเนินธุรกิจในกรณีเกิดภัยพิบัติโดยใช้การจำลองข้อมูล ขึ้นอยู่กับเทคโนโลยีการจำลองข้อมูลที่ใช้ (แบบซิงโครนัส, แบบแอซิงโครนัส, สเตร็ทช์คลัสเตอร์ ฯลฯ) มักจะมีการสูญเสียข้อมูลบางส่วน ทำให้ RPO > 0 นอกจากนี้ การสลับการทำงานของแอปพลิเคชันที่ไซต์ระยะไกลมักใช้เวลานานกว่า ดังนั้น RTO > 0 ดังนั้นจึงจำเป็นต้องปรับแต่งค่า RTO และ RPO ที่ต้องการตามความต้องการเฉพาะของธุรกิจ เพื่อให้ได้ต้นทุนการครอบครองรวม (CTO) ที่เหมาะสมที่สุด ระบบกู้คืนภัยพิบัติระยะไกลมักประกอบด้วยคลัสเตอร์ HA ในพื้นที่และศูนย์ข้อมูล DR ระยะไกล
ความแตกต่างระหว่างทั้งสองยังสามารถพิจารณาได้จากมุมมองอื่นๆ อีกด้วย
ในแง่ของข้อผิดพลาด HA ส่วนใหญ่จัดการกับความล้มเหลวของส่วนประกอบแต่ละชิ้นที่นำไปสู่การถ่ายโอนภาระงานระหว่างเซิร์ฟเวอร์ภายในคลัสเตอร์ ในขณะที่ DR ถูกออกแบบมาเพื่อแก้ไขปัญหาความล้มเหลวในระดับใหญ่ที่ต้องมีการถ่ายโอนภาระงานระหว่างศูนย์ข้อมูล
ในมุมมองของเครือข่าย งานที่อยู่ในระดับของ LAN เป็นหน้าที่ของ HA ในขณะที่งานที่อยู่ในระดับของ WAN จะอยู่ในขอบเขตของ DR
ในมุมมองของการประมวลผลแบบคลาวด์ HA เป็นกลไกภายในสภาพแวดล้อมคลาวด์หนึ่ง เพื่อให้มั่นใจว่าธุรกิจจะดำเนินต่อไปได้ ในขณะที่ DR เป็นกลไกระหว่างสภาพแวดล้อมคลาวด์หลายแห่งเพื่อให้มั่นใจว่าธุรกิจจะดำเนินต่อไปได้
เพิ่มความปลอดภัยให้ข้อมูลด้วยโซลูชันของ Vinchin
Vinchin Backup & Recovery เป็นโซลูชันระดับมืออาชีพที่ออกแบบมาเพื่อปกป้องข้อมูลและการกู้คืนระบบหลังภัยพิบัติสำหรับสภาพแวดล้อมเสมือน รองรับแพลตฟอร์มเสมือนต่างๆ เช่น VMware, Hyper-V, XenServer, Proxmox, XCP-ng, เป็นต้น และฐานข้อมูล, NAS, เซิร์ฟเวอร์ไฟล์, Linux & Windows Server, เป็นต้น โดยได้รับการออกแบบเฉพาะสำหรับสภาพแวดล้อมเสมือน Vinchin จึงมีฟีเจอร์เช่น การสำรองข้อมูลอัตโนมัติ การสำรองข้อมูลแบบไม่ต้องติดตั้งเอเจนต์ ตัวเลือก LAN/LAN-Free การทำสำเนาข้อมูลไปยังสถานที่อื่น การกู้คืนข้อมูลทันที การลดปริมาณข้อมูลซ้ำซ้อน และการเก็บข้อมูลในคลาวด์อย่างปลอดภัย พร้อมระบบเข้ารหัสข้อมูลและการป้องกัน แรนซัมแวร์
ด้วยคุณสมบัติการสำรองข้อมูลแบบไม่ต้องติดตั้งเอเจนต์ ทำให้สามารถผสานรวมเครื่องเสมือนเข้ากับระบบการสำรองข้อมูลได้อย่างรวดเร็ว มีฟีเจอร์การกู้คืนภัยพิบัติ เช่น การเรียกคืนทันที เพื่อเปิดเครื่องเสมือนจากรูปภาพการสำรองข้อมูลภายในไม่กี่วินาที การสำเนาไปยังไซต์อื่นเพื่อจัดเก็บข้อมูลสำรองระยะไกล และการตรวจสอบการสำรองข้อมูลโดยอัตโนมัติเพื่อตรวจสอบความสมบูรณ์ นอกจากนี้ยังช่วยอำนวยความสะดวกในการโยกย้ายเครื่องเสมือนระหว่างไฮเปอร์ไวเซอร์ต่างชนิดกัน เพื่อเปลี่ยนสภาพแวดล้อมเสมือนได้อย่างไร้รอยต่อ
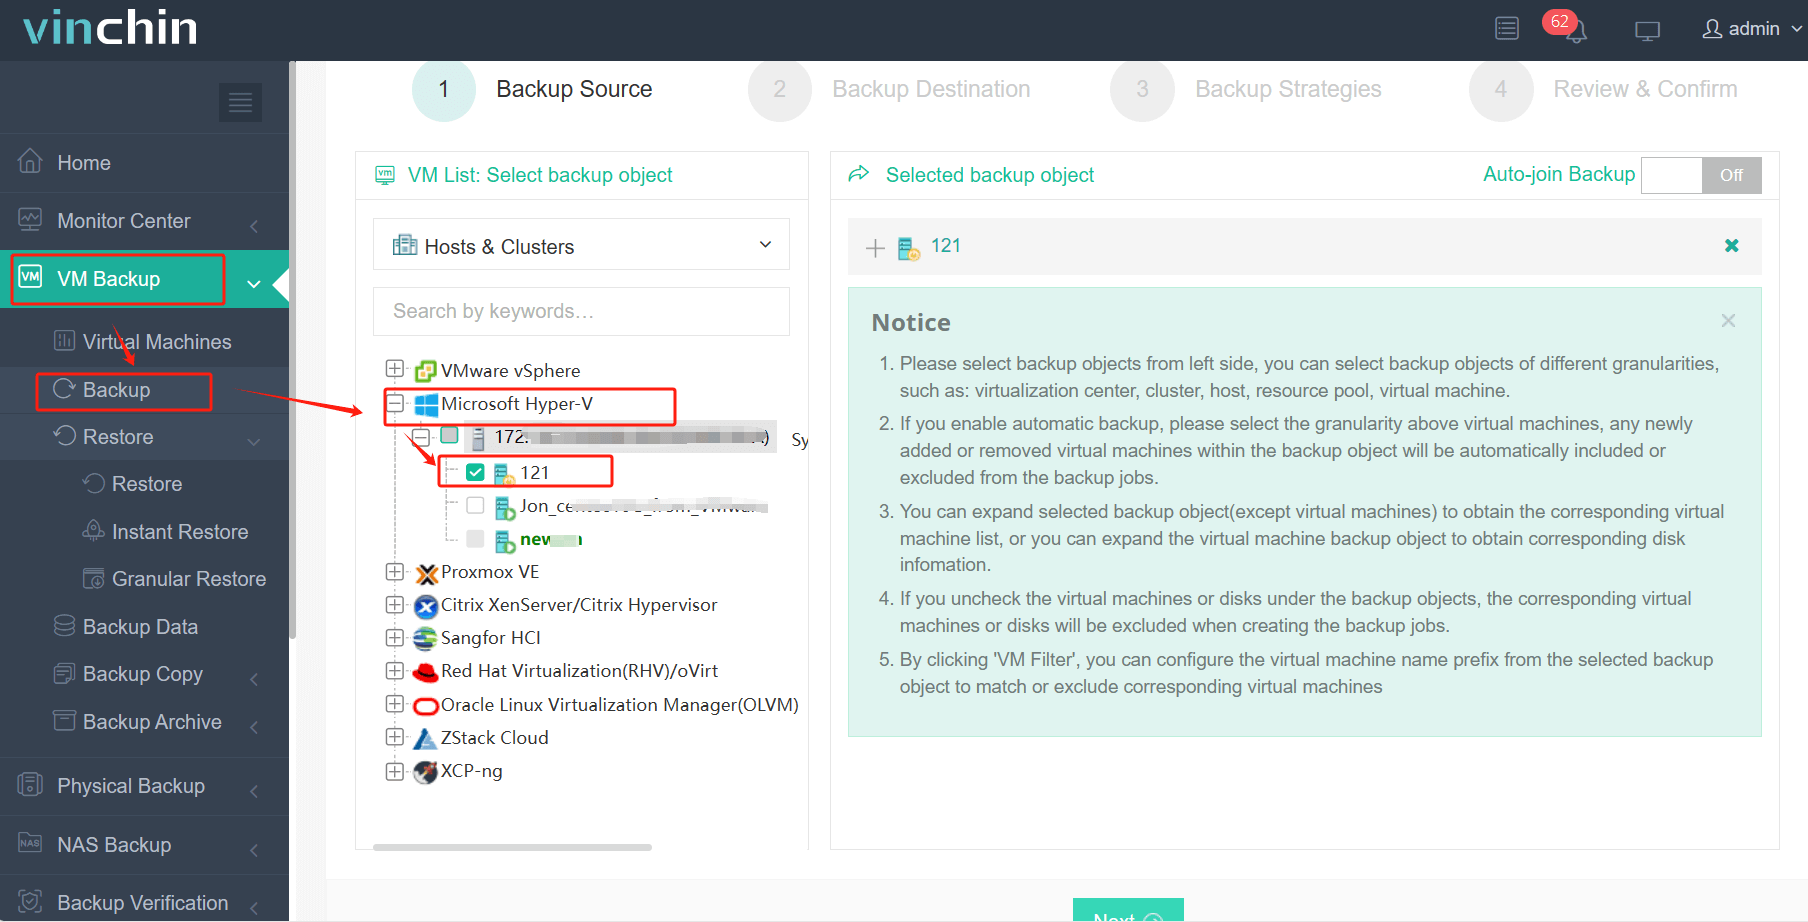
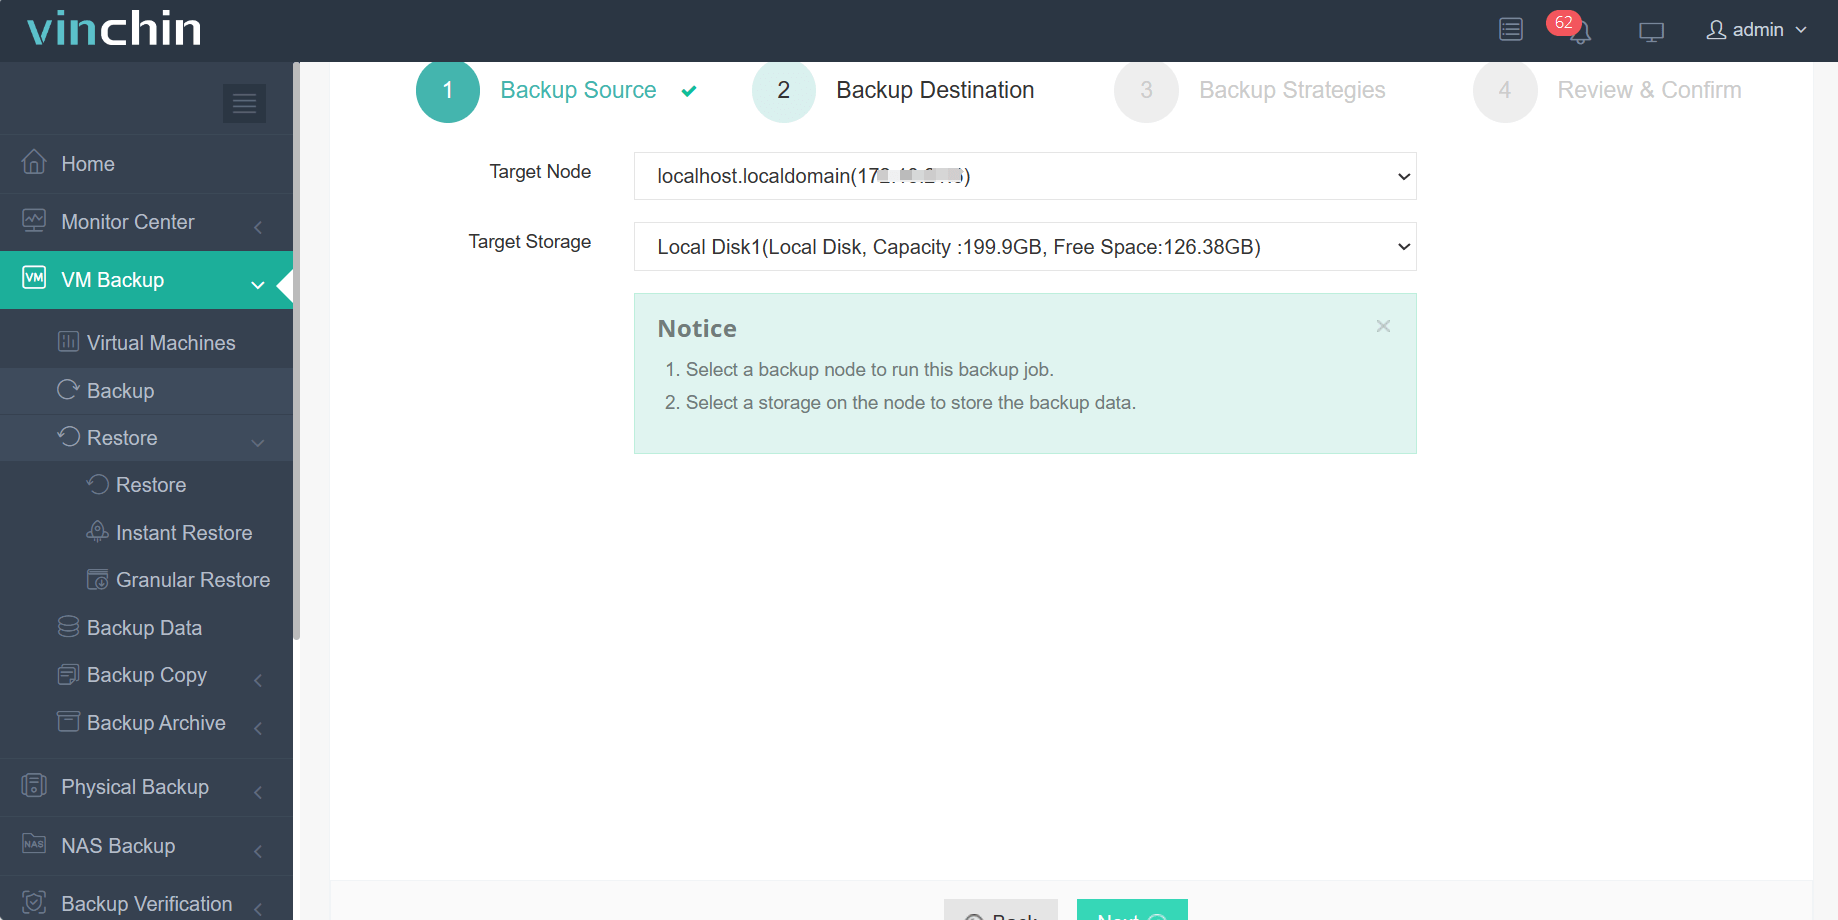
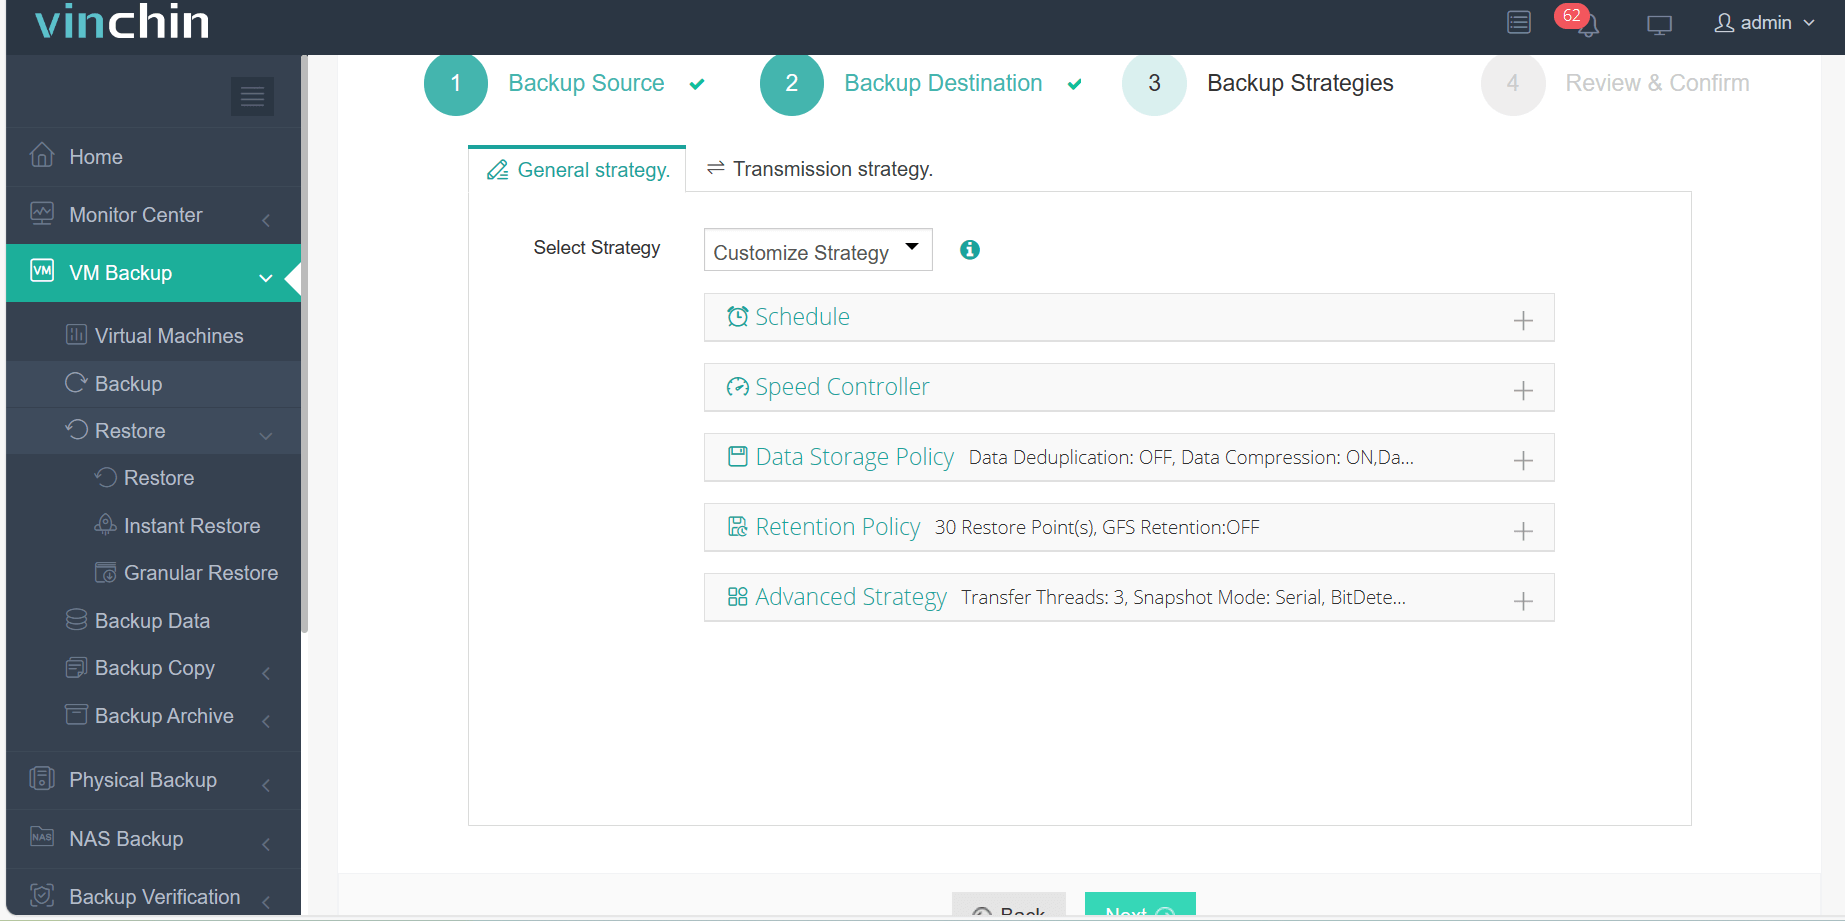
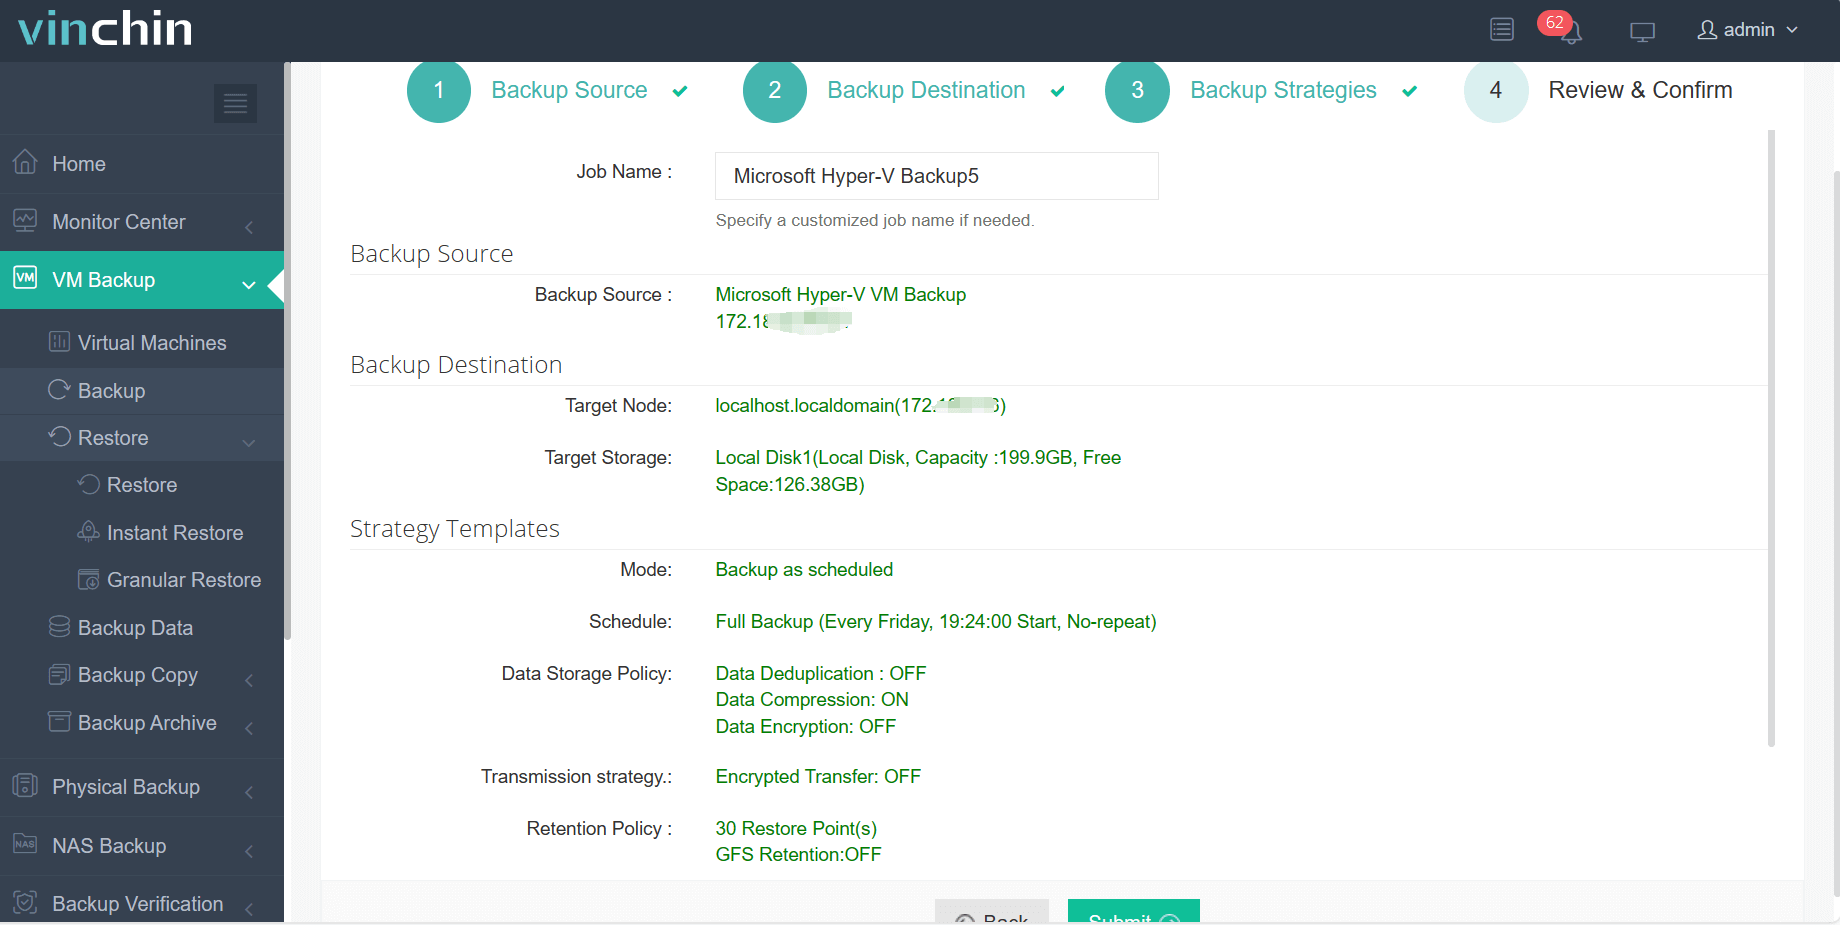
ใช้เพียง 4 ขั้นตอนเท่านั้นในการสำรองเครื่องเสมือนของคุณด้วย Vinchin Backup & Recovery:
1. เลือกวัตถุสำรองข้อมูล
2. เลือกปลายทางสำหรับการสำรองข้อมูล
3. เลือกกลยุทธ์การสำรองข้อมูล
4.ตรวจสอบและส่งงาน
สัมผัสศักยภาพของระบบที่ครอบคลุมนี้ด้วยตัวคุณเอง พร้อมกับ ทดลองใช้งานฟรีเป็นเวลา 60 วัน แจ้งความต้องการเฉพาะของคุณ และคุณจะได้รับโซลูชันที่ปรับแต่งให้เหมาะสมกับสภาพแวดล้อมด้านไอทีของคุณอย่างลงตัว
คำถามที่พบบ่อยเกี่ยวกับ High Availability กับ Disaster Recovery
1. คำถาม: ความแตกต่างระหว่าง High Availability และ Fault Tolerance คืออะไร?
คำตอบ: แม้ทั้งสองอย่างมีเป้าหมายเพื่อให้มั่นใจว่าการทำงานจะดำเนินต่อไป แต่ความพร้อมใช้งานสูง (High Availability) เกี่ยวข้องกับระยะเวลาการกู้คืนที่สั้นหลังจากเกิดข้อผิดพลาด ในขณะที่ความสามารถในการทนต่อข้อผิดพลาด (Fault Tolerance) ถูกออกแบบมาเพื่อให้บริการอย่างต่อเนื่องแม้ในระหว่างที่เกิดข้อผิดพลาด โดยไม่มีช่วงเวลาที่ระบบหยุดทำงาน
2. คำถาม: ความพร้อมใช้งานสูง (High Availability) เหมือนกับการกระจายภาระงาน (load balancing) ไหม?
คำตอบ: ไม่เหมือนกัน แต่การกระจายภาระงานเป็นส่วนหนึ่งของระบบความพร้อมใช้งานสูง โดยจะช่วยกระจายภาระงานไปยังทรัพยากรการประมวลผลหลายตัว ซึ่งช่วยให้มั่นใจได้ว่าเซิร์ฟเวอร์ใดเซิร์ฟเวอร์หนึ่งจะไม่กลายเป็นจุดที่เกิดข้อผิดพลาด
3. คำถาม: ส่วนประกอบหลักของแผนกู้คืนจากภัยพิบัติมีอะไรบ้าง?
คำตอบ: แผนการ DR อย่างครอบคลุมรวมถึงการระบุระบบที่สำคัญ โซลูชันสำรองข้อมูล การจัดเตรียมไซต์สำหรับกู้คืน ค่า RPO และ RTO ที่ชัดเจน และขั้นตอนการกู้คืนโดยละเอียด
สรุป
HA เกี่ยวข้องกับการป้องกันการหยุดทำงานภายในระบบในพื้นที่เดียวกัน ในขณะที่ DR เกี่ยวข้องกับการกู้คืนหลังเกิดภัยพิบัติ ซึ่งอาจอยู่ในสถานที่ทางภูมิศาสตร์ที่แตกต่างกัน ทั้งสองแนวทางมีความสำคัญต่อการดำเนินงานของธุรกิจอย่างต่อเนื่อง แต่มีวิธีการใช้งานที่แตกต่างกัน ขึ้นอยู่กับระดับความเสี่ยงที่องค์กรยอมรับได้ ความต้องการทางธุรกิจ และทรัพยากรที่มีอยู่