การสำรองข้อมูลทำให้มั่นใจว่าในกรณีที่เกิดการสูญเสียข้อมูลจากการเสียหายของฮาร์ดแวร์ ภัยพิบัติทางธรรมชาติ ความผิดพลาดของมนุษย์ หรือการโจมตีจากภัยคุกคาม องค์กรสามารถกลับมาดำเนินงานได้อย่างรวดเร็ว ลดระยะเวลาหยุดทำงานและความเสียหายให้น้อยที่สุด หนึ่งปัญหาที่มักถูกมองข้ามแต่มีความสำคัญมากในกระบวนการสำรองข้อมูลคือ ข้อมูลซ้ำซ้อน ข้อมูลซ้ำซ้อนหมายถึงข้อมูลที่เหมือนกันหรือซ้ำซ้อนภายในชุดข้อมูลสำรอง ปัญหานี้อาจเกิดจากการสำรองข้อมูลเดิมซ้ำหลายครั้ง การไม่ลบเวอร์ชันเก่าหลังอัปเดต หรือกลยุทธ์การสำรองข้อมูลที่ไม่เหมาะสม
ปัญหาที่เกิดจากข้อมูลซ้ำซ้อน
ข้อมูลซ้ำซ้อนไม่เพียงแต่ใช้พื้นที่จัดเก็บอันมีค่าและทำให้ต้นทุนการจัดเก็บเพิ่มสูงขึ้น แต่ยังทำให้กระบวนการสำรองข้อมูลและการกู้คืนข้อมูลซับซ้อนและไม่มีประสิทธิภาพมากขึ้น เมื่อชุดข้อมูลสำรองมีข้อมูลซ้ำซ้อนจำนวนมาก การดำเนินการสำรองข้อมูลแต่ละครั้งจะต้องประมวลผลและถ่ายโอนเนื้อหานี้ที่ซ้ำซ้อน ทำให้ทรัพยากรเครือข่ายสิ้นเปลืองและเวลาในการสำรองข้อมูลยาวนานขึ้น ในระหว่างการกู้คืนข้อมูล ข้อมูลซ้ำซ้อนยังเพิ่มความยากและความใช้เวลานานขึ้น เนื่องจากระบบจะต้องกรองและระบุไฟล์ที่จำเป็นต้องกู้คืนจริงๆ
นอกจากนี้ ข้อมูลที่ซ้ำกันยังสามารถทำให้การจัดการข้อมูลมีความซับซ้อนมากขึ้น ข้อมูลที่ซ้ำกันจำนวนมากจะทำให้การจัดการข้อมูลซับซ้อนยิ่งขึ้น ส่งผลให้ความยากลำบากในการดูแลรักษาระดับหนึ่งเพิ่มขึ้น และเพิ่มค่าใช้จ่ายอีกด้วย นอกจากนั้น ข้อมูลที่ซ้ำกันอาจทำให้มองไม่เห็นการเปลี่ยนแปลงที่แท้จริงของข้อมูล ซึ่งรบกวนกระบวนการวิเคราะห์ข้อมูล
ดังนั้น การจัดการปัญหาข้อมูลซ้ำในข้อมูลสำรองจึงมีความสำคัญอย่างยิ่ง โดยการใช้เทคนิคการลดข้อมูลซ้ำอย่างมีประสิทธิภาพ กระบวนการสำรองข้อมูลสามารถถูกปรับให้มีประสิทธิภาพมากขึ้น ช่วยเพิ่มประสิทธิภาพในการจัดเก็บและสำรองข้อมูล ลดต้นทุน และรับประกันความถูกต้องและการจัดการข้อมูลได้ง่ายขึ้น
ประเภทของข้อมูลซ้ำซ้อนในการสำรองข้อมูล
การซ้ำกันในระดับไฟล์ มีการสำรองไฟล์ทั้งหมดหลายครั้ง โดยแต่ละครั้งจะเป็นการคัดลอกไฟล์ครบถ้วน ซึ่งพบได้บ่อยในการสำรองข้อมูลแบบเต็มรูปแบบของโฟลเดอร์หรือระบบโดยรวม
การซ้ำกันของข้อมูลในระดับบล็อก บล็อกข้อมูลภายในไฟล์ถูกบันทึกซ้ำซ้อนไปยังการสำรองข้อมูลหลายชุด การซ้ำกันนี้อาจไม่ชัดเจนนัก แต่สามารถทำให้สูญเสียพื้นที่จัดเก็บข้อมูลไปอย่างมาก โดยทั่วไปจำเป็นต้องใช้เทคโนโลยีการลบข้อมูลซ้ำ (deduplication) พิเศษเฉพาะเพื่อตรวจจับและกำจัดข้อมูลที่ซ้ำกัน
การซ้ำเวอร์ชัน มีการบันทึกไฟล์เดียวกันหลายเวอร์ชัน โดยแต่ละเวอร์ชันมีความแตกต่างกันเล็กน้อย แต่มีข้อมูลหลักที่เหมือนกันเป็นส่วนใหญ่
การทำซ้ำของเมตาดาต้า ระหว่างการสำรองข้อมูล เมตาดาต้าของไฟล์ (เช่น เวลาที่สร้าง เวลาที่แก้ไข) อาจถูกบันทึกซ้ำได้ แม้ว่าข้อมูลเหล่านี้จะใช้พื้นที่ไม่มากนัก แต่ในการสำรองข้อมูลจำนวนมาก ข้อมูลดังกล่าวสามารถสะสมจนมีปริมาณมากได้
การลบข้อมูลซ้ำคืออะไร?
เทคโนโลยีการลบข้อมูลซ้ำช่วยเพิ่มประสิทธิภาพการใช้พื้นที่จัดเก็บโดยการระบุและลบบล็อกข้อมูลที่ซ้ำกันออกกระบวนการนี้อาศัยการสร้างลายเซ็นดิจิทัล (ลายนิ้วมือ) ที่ไม่ซ้ำกันสำหรับแต่ละบล็อกข้อมูล และใช้การจัดเก็บแฮชเพื่อตรวจจับข้อมูลที่ซ้ำกันขึ้นอยู่กับช่วงเวลาที่นำไปใช้ การทำซ้ำซ้อนสามารถจัดแบ่งได้เป็นสองประเภทหลัก ได้แก่ แบบอินไลน์ (ออนไลน์) และแบบหลังการประมวลผล (ออฟไลน์)การลบข้อมูลซ้ำแบบอินไลน์จะถูกนำไปใช้ก่อนที่ข้อมูลจะถูกเขียนลงในพื้นที่จัดเก็บ โดยจัดเก็บเฉพาะส่วนของข้อมูลที่ไม่ซ้ำกันเท่านั้น ในขณะที่การลบข้อมูลซ้ำหลังกระบวนการจะช่วยเพิ่มประสิทธิภาพของข้อมูลหลังจากที่ข้อมูลถูกเขียนแล้วนอกจากนี้ ตามสถานที่ดำเนินการ สามารถแบ่งการลบซ้ำข้อมูลออกเป็นการลบซ้ำข้อมูลแบบอิงจากต้นทางและแบบอิงจากปลายทาง การดำเนินการกำจัดข้อมูลซ้ำแบบอิงแหล่งที่มาจะประมวลผลข้อมูลก่อนส่ง ช่วยลดปริมาณการส่งผ่านเครือข่ายได้อย่างมีประสิทธิภาพ
ในอดีต SIS (Single Instance Storage) เป็นเทคโนโลยีการทำลายซ้ำที่ทำงานในระดับไฟล์ เทคโนโลยีการทำลายซ้ำแบบทันสมัยทำงานในระดับบล็อกข้อมูล ซึ่งให้ผลการลบข้อมูลซ้ำได้ดีกว่า แต่มีความซับซ้อนในการใช้งานสูงกว่า การสำรองข้อมูลแบบเพิ่มเป็นระยะสามารถลดการสำรองข้อมูลซ้ำได้บางส่วน แต่เนื่องจากทำงานในระดับไฟล์ ทำให้มีความละเอียดต่ำ และการใช้งานการสำรองข้อมูลแบบเพิ่มเป็นระยะในระยะยาวไม่คุ้มค่า เนื่องจากกระบวนการกู้คืนข้อมูลมีความซับซ้อน
เทคโนโลยีการลดข้อมูลซ้ำซ้อนไม่เพียงแต่เหมาะสำหรับระบบสำรองข้อมูลและจัดเก็บเอกสารเท่านั้น แต่ยังสามารถนำไปใช้กับระบบจัดเก็บข้อมูลแบบออนไลน์ เกือบออฟไลน์ และออฟไลน์ รวมถึงระบบไฟล์ ตัวจัดการปริมาณข้อมูล NAS SAN และสถานการณ์อื่นๆ
จะรู้ได้อย่างไรว่าการลบข้อมูลซ้ำซ้อนมีประสิทธิภาพกับข้อมูลหรือไม่
ประสิทธิภาพของการลบข้อมูลซ้ำซ้อนขึ้นอยู่กับปัจจัยหลายประการ:
ก. ปริมาณการเปลี่ยนแปลงข้อมูล ยิ่งข้อมูลเปลี่ยนแปลงน้อยลงเท่าไร การลดซ้ำซ้อนก็จะมีประสิทธิภาพมากยิ่งขึ้นเท่านั้น
ข. ความสามารถในการบีบอัดข้อมูล เทคโนโลยีการบีบอัดมักใช้ร่วมกับการลดซ้ำของข้อมูล ข้อมูลที่สามารถบีบอัดได้สูงสามารถประหยัดแบนด์วิธและพื้นที่จัดเก็บได้อย่างมาก แม้ว่าอัตราการลดซ้ำจะไม่สูงก็ตาม
ค. ระยะเวลาการเก็บข้อมูล ยิ่งระยะเวลาการเก็บข้อมูลยาวนานเท่าใด การทำซ้ำข้อมูลก็จะยิ่งมีข้อได้เปรียบมากขึ้นเท่านั้น เนื่องจากสามารถลดความต้องการพื้นที่จัดเก็บข้อมูลได้อย่างมาก
การจัดทำกลยุทธ์การสำรองข้อมูลอย่างมีเหตุผลเพื่อลดข้อมูลซ้ำซ้อน
ในการจัดทำกลยุทธ์การสำรองข้อมูลอย่างมีเหตุผลเพื่อลดข้อมูลซ้ำซ้อน สามารถดำเนินการตามมาตรการต่อไปนี้ได้:
1. การรวมการสำรองข้อมูลแบบเต็มรูปแบบและการสำรองข้อมูลเพิ่มเติม ทำการสำรองข้อมูลแบบเต็มรูปแบบในช่วงเริ่มต้นหรือหลังจากการอัปเดตข้อมูลที่สำคัญ เพื่อสร้างสแน็ปช็อตข้อมูลอย่างสมบูรณ์ ใช้การสำรองข้อมูลเพิ่มเติมรายวันเพื่อบันทึกการเปลี่ยนแปลงใหม่ๆ ซึ่งจะช่วยลดข้อมูลซ้ำซ้อนและประหยัดทรัพยากร
2. ดำเนินการตามนโยบายการจัดเก็บและลบข้อมูล ตั้งแผนการจัดเก็บเป็นประจำเพื่อย้ายข้อมูลที่จำเป็นแต่เข้าถึงน้อยไปยังพื้นที่จัดเก็บข้อมูลที่มีค่าใช้จ่ายต่ำ ระบุและล้างข้อมูลที่ซ้ำซ้อนหรือล้าสมัย กำหนดระยะเวลาการเก็บรักษาข้อมูล และทำให้กระบวนการล้างข้อมูลเป็นอัตโนมัติ
3. เพิ่มประสิทธิภาพกระบวนการสำรองข้อมูล เลือกซอฟต์แวร์สำรองข้อมูลที่รองรับการลบข้อมูลซ้ำซ้อนโดยอัตโนมัติในระหว่างการสำรองข้อมูล บีบอัดและเข้ารหัสข้อมูลที่จัดเก็บเพื่อประหยัดพื้นที่เพิ่มเติมและยกระดับความปลอดภัย
4. การตรวจสอบและการปรับกลยุทธ์อย่างต่อเนื่อง ตรวจสอบความมีประสิทธิภาพของข้อมูลสำรองอย่างสม่ำเสมอ ติดตามการใช้งานพื้นที่จัดเก็บข้อมูล และปรับเปลี่ยนกลยุทธ์การสำรองข้อมูลและการจัดเก็บข้อมูลตามความจำเป็นโดยพิจารณาจากการเปลี่ยนแปลงทางธุรกิจ เพื่อให้มั่นใจว่าการทำงานมีประสิทธิภาพและสอดคล้องกับข้อกำหนด
ซอฟต์แวร์สำรองข้อมูลตัวใดดีที่สุด?
Vinchin Backup & Recovery เป็นซอฟต์แวร์สำรองข้อมูลเครื่องเสมือนระดับมืออาชีพที่รองรับแพลตฟอร์มเสมือนจริงมากกว่า 10 แพลตฟอร์ม ได้แก่ VMware, Hyper-V, Proxmox, XenServer และ oVirt เป็นต้น ซึ่งให้คุณสมบัติการสำรองและการกู้คืนเครื่องเสมือนที่ยอดเยี่ยม และยังสามารถทำการย้ายข้อมูลข้ามแพลตฟอร์มได้อีกด้วย
แน่นอนว่า Vinchin Backup & Recovery ยังรวมถึงฟังก์ชันการกำจัดข้อมูลซ้ำและการบีบอัดข้อมูล มันมีคุณสมบัติการกำจัดข้อมูลซ้ำที่สามารถปรับขนาดของบล็อกได้ ซึ่งมีข้อได้เปรียบมากกว่าการกำจัดข้อมูลซ้ำแบบคงที่แบบดั้งเดิม โดยช่วยลดพื้นที่จัดเก็บข้อมูลสำรองได้อย่างมีประสิทธิภาพ
ด้วยการใช้เทคโนโลยีการลบข้อมูลซ้ำและการบีบอัดของ Vinchin คุณสามารถเพิ่มความเร็วในการสำรองข้อมูลระหว่างกระบวนการจัดเก็บข้อมูลสำรอง ลดทรัพยากรการจัดเก็บที่ถูกใช้โดยข้อมูลสำรอง และยังช่วยกำจัดความเสี่ยงของการเสียหายของข้อมูลทั่วโลกที่เกิดจากการลบข้อมูลซ้ำแบบทั่วโลก
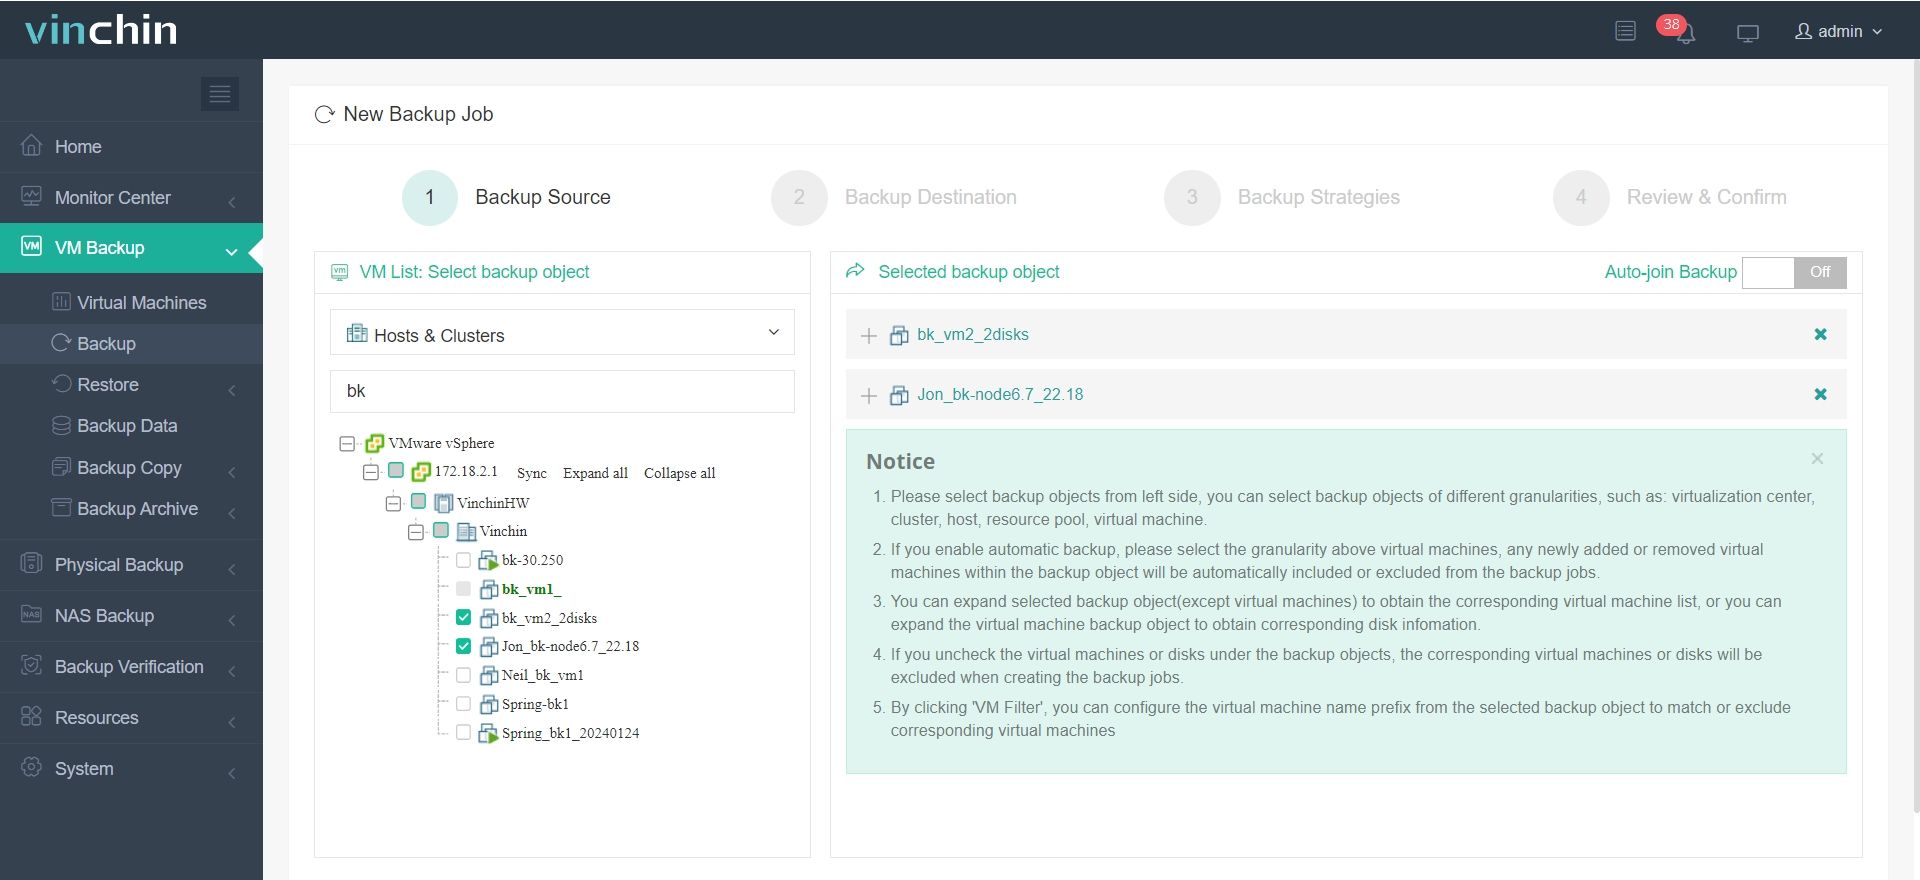
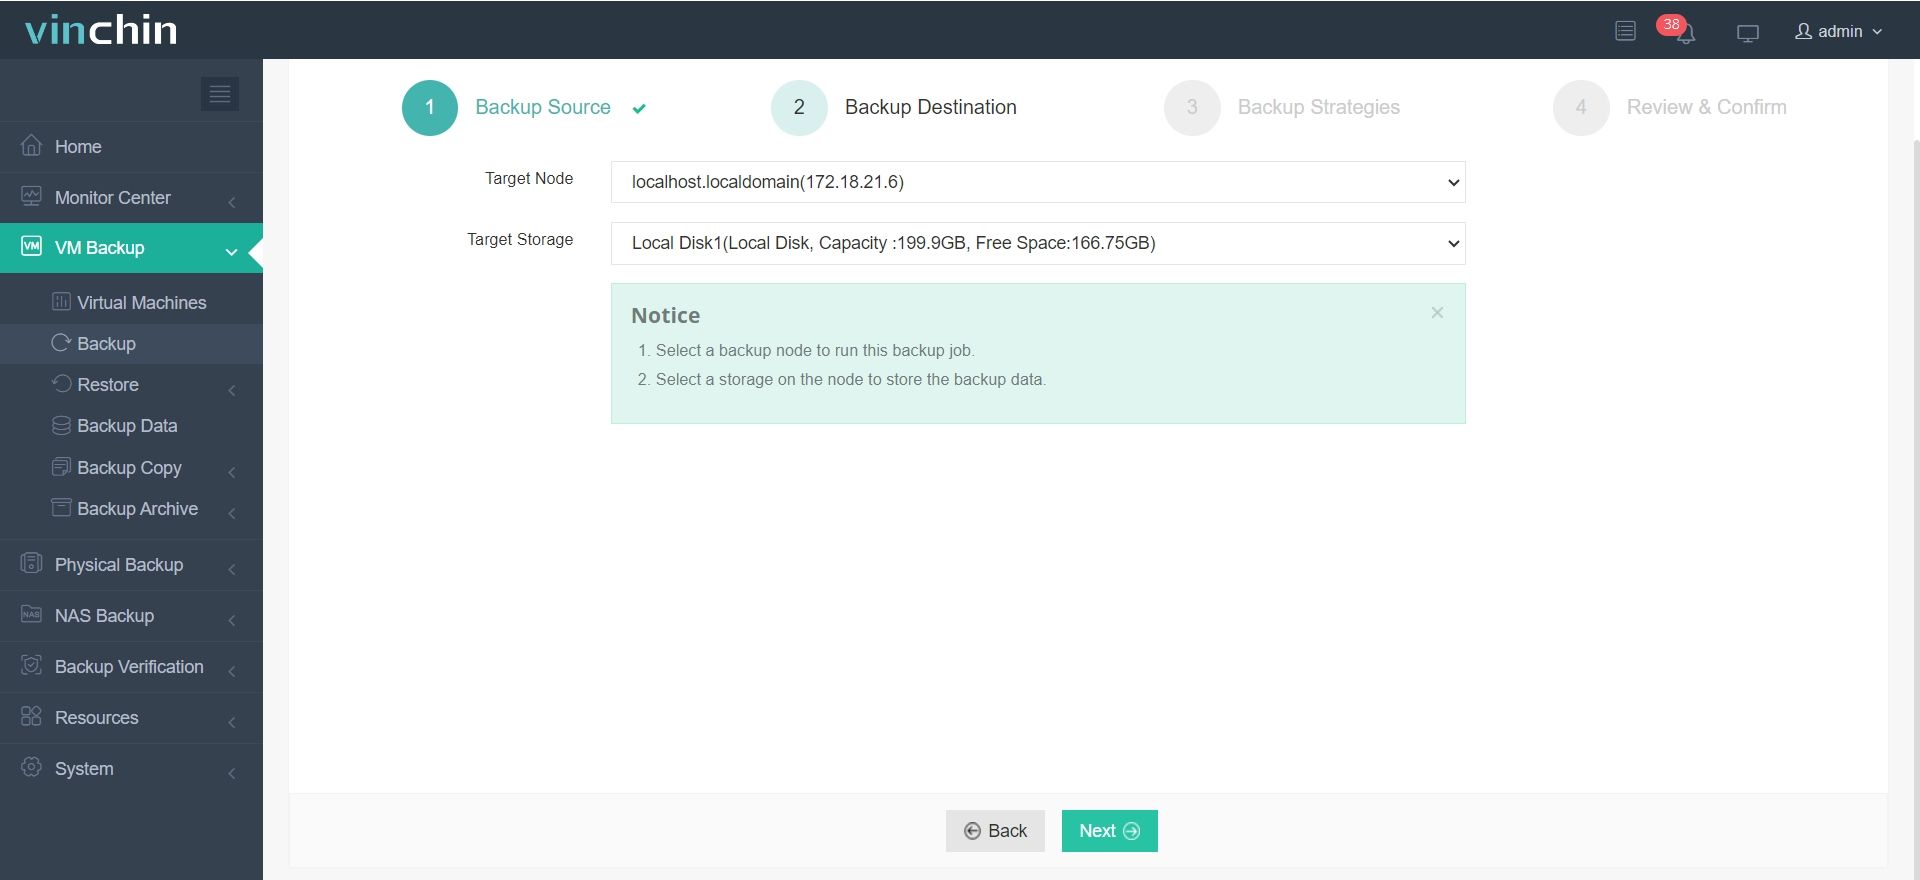
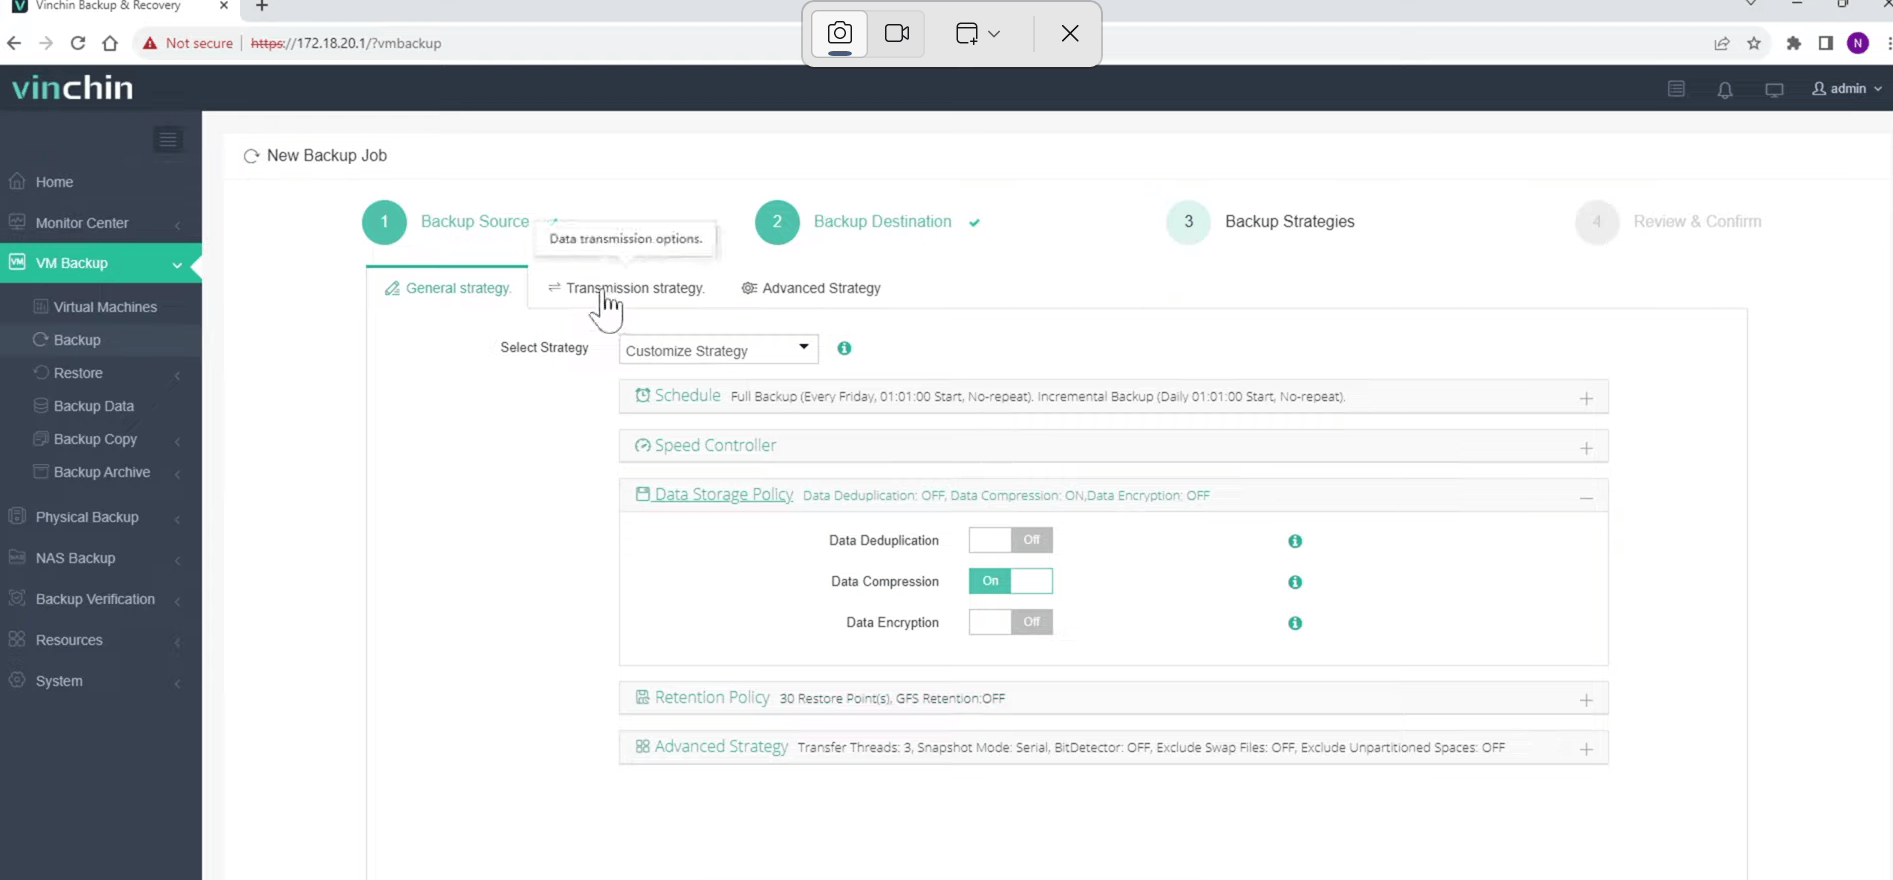
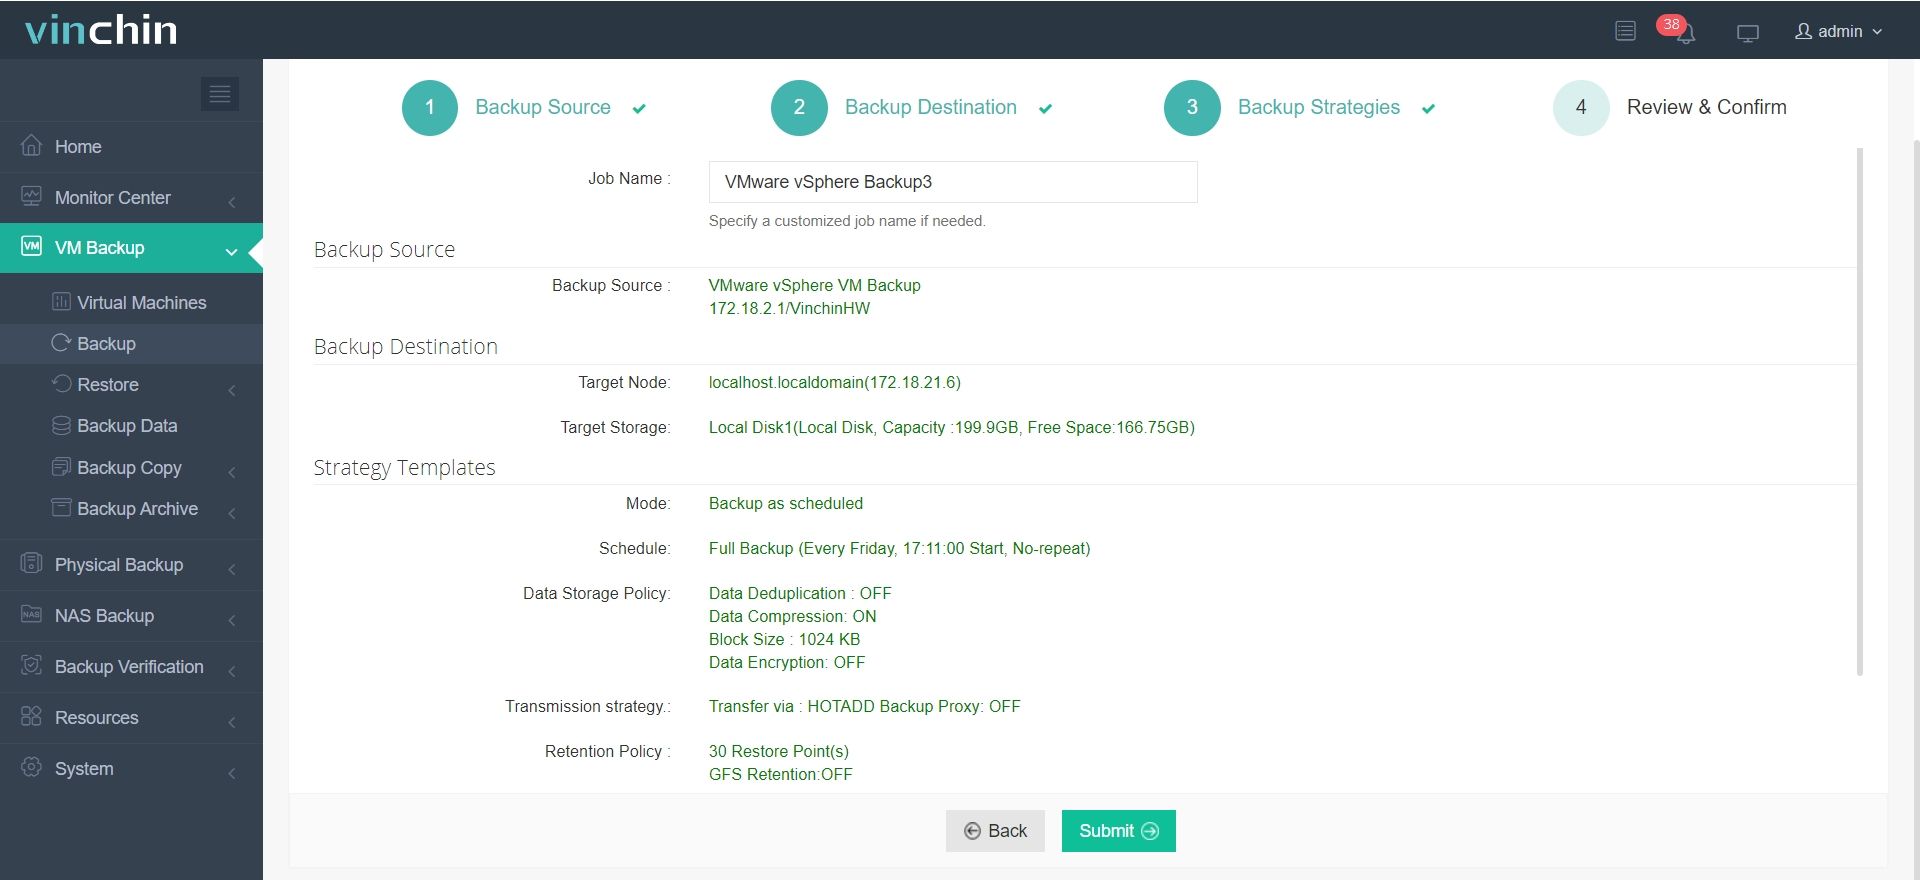
ในการเปิดใช้งานการลบข้อมูลซ้ำซ้อนระหว่างการสำรองข้อมูล ให้ทำตามขั้นตอนง่ายๆ เหล่านี้:
1. เลือกเครื่องเสมือนที่คุณต้องการสำรองข้อมูล
2. เลือกปลายทางสำหรับการสำรองข้อมูล
3. กำหนดกลยุทธ์การสำรองข้อมูล
ในส่วน "นโยบายการจัดเก็บข้อมูล" คุณสามารถเลือกว่าจะเปิดใช้งานการลบข้อมูลซ้ำและการบีบอัดหรือไม่
4. ยืนยันงานสำรองข้อมูล
นอกจากคุณสมบัติที่กล่าวมาแล้ว Vinchin ยังมีคุณสมบัติขั้นสูงอื่นๆ อีกมากมายที่รอให้คุณได้ค้นพบ กดปุ่มด้านล่างเพื่อเริ่มต้น ทดลองใช้งานฟรี 60 วันพร้อมฟังก์ชันครบถ้วน
คำถามที่พบบ่อยเกี่ยวกับการลดข้อมูลซ้ำซ้อนในการสำรองข้อมูล FAQs
1. คำคำถาม: ประเภทข้อมูลใดที่เหมาะกับการลดข้อมูลซ้ำซ้อน และประเภทใดที่ไม่เหมาะ?
คำตอบ: การลบข้อมูลซ้ำซ้อนเหมาะสำหรับข้อมูลทุกประเภท รวมถึงเอกสารสำนักงาน ฐานข้อมูล ไฟล์มัลติมีเดีย และเครื่องเสมือน แม้ว่าข้อมูลบางประเภทอาจไม่แสดงผลการลดซ้ำซ้อนอย่างชัดเจนในระหว่างการสำรองข้อมูลครั้งแรกเนื่องจากลักษณะของข้อมูลเอง แต่ข้อดีของการลดซ้ำซ้อนจะปรากฏชัดเจนยิ่งขึ้นในการสำรองข้อมูลครั้งถัดไป ยิ่งทำการสำรองข้อมูลบ่อยครั้งและช่วงเวลาสั้นลงเท่าใด อัตราการลดซ้ำซ้อนก็จะยิ่งสูงขึ้นเท่านั้น
2. คำถาม: การลดข้อมูลซ้ำแบบบล็อกความยาวคงที่คืออะไร และการลดข้อมูลซ้ำแบบบล็อกความยาวตัวแปรคืออะไร?
คำตอบ: การลบข้อมูลซ้ำแบบบล็อกความยาวคงที่จะแบ่งข้อมูลออกเป็นบล็อกขนาดเท่ากัน แล้วระบุข้อมูลซ้ำโดยการเปรียบเทียบเนื้อหาของแต่ละบล็อก วิธีนี้มีความเรียบง่าย แต่อาจพลาดโอกาสในการกำจัดข้อมูลซ้ำหากข้อมูลที่เหมือนกันเลื่อนตำแหน่งไปเพียงเล็กน้อย ในขณะเดียวกัน การลบข้อมูลซ้ำแบบบล็อกความยาวตัวแปรจะแบ่งข้อมูลออกเป็นบล็อกที่มีขนาดแตกต่างกันตามลักษณะของเนื้อหา ซึ่งช่วยให้ตรวจจับข้อมูลซ้ำได้อย่างแม่นยำมากขึ้น แม้ข้อมูลจะมีการเลื่อนตำแหน่งก็ตาม ส่งผลให้การลบข้อมูลซ้ำแบบความยาวตัวแปรมีประสิทธิภาพมากกว่าในการลดพื้นที่จัดเก็บ แม้ว่าวิธีนี้จะมีความซับซ้อนในการดำเนินการมากกว่า
ข้อสรุป
ข้อมูลซ้ำฟซ้อนไม่เพียงแต่สิ้นเปลืองพื้นที่จัดเก็บ ทำให้ต้นทุนการดำเนินงานขององค์กรเพิ่มขึ้น แต่ยังส่งผลต่อประสิทธิภาพของการสำรองและกู้คืนข้อมูล ทำให้การจัดการข้อมูลซับซ้อนมากขึ้น ดังนั้น การใช้เทคโนโลยีการลดข้อมูลซ้ำอย่างมีประสิทธิภาพจึงเป็นสิ่งสำคัญ โดยผ่านกระบวนการลดข้อมูลซ้ำ องค์กรสามารถปรับการใช้พื้นที่จัดเก็บให้มีประสิทธิภาพ ลดต้นทุน และเพิ่มประสิทธิภาพและความแม่นยำในการจัดการข้อมูล