Apakah Anda mencari solusi backup VM yang handal? Coba Vinchin Backup & Recovery!↘ Unduh Versi Percobaan Gratis Backup data memastikan bahwa dalam kejadian kehilangan data yang disebabkan oleh kegagalan perangkat keras, bencana alam, kesalahan manusia, atau serangan jahat, perusahaan dapat segera memulai kembali operasionalnya, meminimalkan waktu henti dan kerugian. Salah satu masalah yang sering diabaikan namun penting dalam proses backup data adalah duplikasi data. Duplikasi data mengacu pada data yang identik atau berlebihan di dalam kumpulan data backup. Masalah ini bisa terjadi karena melakukan backup data yang sama secara berulang, gagal menghapus versi lama setelah pembaruan, atau strategi backup yang tidak tepat.
Masalah yang Disebabkan oleh Data Duplikat
Data duplikat tidak hanya menghabiskan ruang penyimpanan bernilai dan meningkatkan biaya penyimpanan, tetapi juga dapat membuat proses cadangan dan pemulihan menjadi lebih kompleks dan tidak efisien. Saat kumpulan cadangan berisi sejumlah besar data duplikat, setiap operasi pencadangan harus memproses dan mentransmisikan konten yang tidak diperlukan ini, membuang sumber daya jaringan dan memperpanjang waktu pencadangan. Selama pemulihan data, data duplikat juga meningkatkan tingkat kesulitan dan waktu yang dibutuhkan, karena sistem harus menyaring dan mengidentifikasi file yang benar-benar perlu dipulihkan.
Selain itu, data duplikat dapat memperumit manajemen data. Jumlah data duplikat yang besar membuat manajemen data lebih kompleks, meningkatkan kesulitan dan biaya pemeliharaan. Selain itu, data duplikat dapat menyamarkan perubahan sebenarnya dalam data, mengganggu analisis data.
Oleh karena itu, menangani masalah data duplikat dalam cadangan sangatlah penting. Dengan menerapkan teknik deduplikasi yang efektif, proses pencadangan dapat dioptimalkan, meningkatkan efisiensi penyimpanan dan pencadangan, mengurangi biaya, serta memastikan akurasi dan keterkelolaan data.
Kategori Data Duplikat dalam Cadangan
Duplikasi Tingkat Berkas: Seluruh berkas dicadangkan beberapa kali, dengan setiap pencadangan merupakan salinan lengkap dari berkas tersebut. Hal ini umum terjadi pada pencadangan penuh dari folder atau seluruh sistem.
Duplikasi Tingkat Blok Data: Blok data di dalam sebuah berkas secara berlebihan tersimpan dalam beberapa cadangan. Hal ini tergolong halus tetapi dapat menyebabkan pemborosan ruang penyimpanan yang signifikan. Duplikasi tingkat blok biasanya memerlukan teknologi deduplikasi khusus untuk mendeteksi dan menghilangkannya.
Duplikasi Versi: Banyak versi dari file yang sama disimpan, dengan setiap versi memiliki perbedaan kecil tetapi sebagian besar data sama.
Duplikasi Metadata: Selama pencadangan, metadata file (misalnya, waktu pembuatan, waktu modifikasi) juga dapat tersimpan secara berlebihan. Meskipun data ini menempati ruang yang relatif kecil, dalam pencadangan skala besar, data ini dapat menumpuk secara signifikan.
Apa Itu Deduplikasi?
Teknologi deduplikasi mengoptimalkan penggunaan ruang penyimpanan dengan mengidentifikasi dan menghilangkan blok data yang duplikat.Proses ini mengandalkan pembuatan tanda tangan digital (sidik jari) unik untuk setiap blok data dan menggunakan penyimpanan hash untuk mendeteksi duplikasi.Ter Bergantung pada kapan deduplikasi diterapkan, deduplikasi dapat diklasifikasikan menjadi dua jenis utama: inline (online) dan post-process (offline).Deduplikasi inline diterapkan sebelum data ditulis ke penyimpanan, menyimpan hanya segmen data yang unik, sedangkan deduplikasi pasca-proses mengoptimalkan data setelah data tersebut ditulis.Selain itu, berdasarkan lokasi eksekusi, deduplikasi dapat dibagi menjadi deduplikasi berbasis sumber dan berbasis target. Source-based deduplication memproses data sebelum dikirimkan, secara efektif mengurangi volume transmisi jaringan.
Pada masa lalu, SIS (Single Instance Storage) merupakan bentuk teknologi deduplikasi yang beroperasi pada tingkat file. Teknologi deduplikasi modern bekerja pada tingkat blok data, memberikan efek deduplikasi yang lebih baik namun dengan kompleksitas implementasi yang lebih tinggi. Backup inkremental dapat mengurangi duplikasi backup sampai tingkat tertentu, tetapi karena beroperasi pada tingkat file, tingkat granularitasnya buruk, dan penggunaan backup inkremental dalam jangka panjang tidak praktis karena kompleksitas proses pemulihan.
Teknologi deduplikasi tidak hanya cocok untuk sistem cadangan dan arsip, tetapi juga dapat diterapkan pada sistem penyimpanan data online, nearline, dan offline, termasuk sistem file, manajer volume, NAS, SAN, dan skenario lainnya.
Cara Mengetahui Jika Deduplikasi Efektif untuk Data?
Keefektifan deduplikasi bergantung pada beberapa faktor:
A. Jumlah Perubahan Data: Semakin sedikit data berubah, semakin efektif deduplikasi yang dilakukan.
B. Kompresibilitas Data: Teknologi kompresi biasanya digunakan bersama dengan deduplikasi. Data yang sangat dapat dikompresi dapat menghemat bandwidth dan penyimpanan secara signifikan meskipun rasio deduplikasi tidak tinggi.
C. Periode Retensi Data: Semakin lama periode retensi data, semakin menguntungkan deduplikasi, karena dapat secara signifikan mengurangi kebutuhan ruang penyimpanan.
Menetapkan Strategi Cadangan yang Wajar untuk Mengurangi Data Duplikat
Untuk menetapkan strategi cadangan yang wajar untuk mengurangi data duplikat, langkah-langkah berikut dapat diambil:
1. Gabungkan Cadangan Penuh dan Cadangan Bertahap: Lakukan cadangan penuh pada awalnya atau setelah pembaruan data penting untuk membuat salinan lengkap data; gunakan cadangan bertahap harian untuk mencatat perubahan baru, mengurangi data duplikat, dan menghemat sumber daya.
2. Terapkan Kebijakan Arsip dan Pembersihan: Tetapkan rencana pengarsipan berkala untuk memindahkan data yang jarang diakses namun masih diperlukan ke penyimpanan berbiaya rendah; identifikasi dan hapus data yang duplikat atau sudah kedaluwarsa, tentukan periode retensi data, serta otomatisasi proses pembersihan.
3. Optimalkan Proses Cadangan: Pilih perangkat lunak cadangan yang mendukung deduplikasi, yang secara otomatis menghapus data duplikat selama pencadangan; kompresi dan enkripsi data arsip untuk lebih menghemat ruang dan meningkatkan keamanan.
4. Pemantauan Berkelanjutan dan Penyesuaian Strategi: Secara berkala memverifikasi efektivitas data cadangan, memantau penggunaan penyimpanan, dan menyesuaikan strategi pencadangan dan pengarsipan sesuai kebutuhan berdasarkan perubahan bisnis untuk memastikan operasi yang efisien dan kepatuhan.
Software Backup Mana yang Terbaik?
Vinchin Backup & Recovery adalah software backup mesin virtual profesional yang mendukung lebih dari 10 platform virtualisasi, termasuk VMware, Hyper-V, Proxmox, XenServer, dan oVirt, dll. Software ini menyediakan fitur backup dan pemulihan mesin virtual yang luar biasa serta juga mendukung migrasi lintas platform.
Tentu saja, Vinchin Backup & Recovery juga mencakup fungsi deduplikasi dan kompresi. Vinchin menawarkan fitur deduplikasi dengan ukuran blok yang dapat disesuaikan, yang lebih unggul dibandingkan deduplikasi tetap tradisional, sehingga secara efektif mengurangi ruang penyimpanan cadangan.
Dengan mengadopsi teknologi deduplikasi dan kompresi Vinchin, Anda dapat meningkatkan kecepatan cadangan selama proses penyimpanan cadangan dan mengurangi penggunaan sumber daya penyimpanan oleh data cadangan, sekaligus menghilangkan risiko kerusakan data global yang disebabkan oleh deduplikasi global.
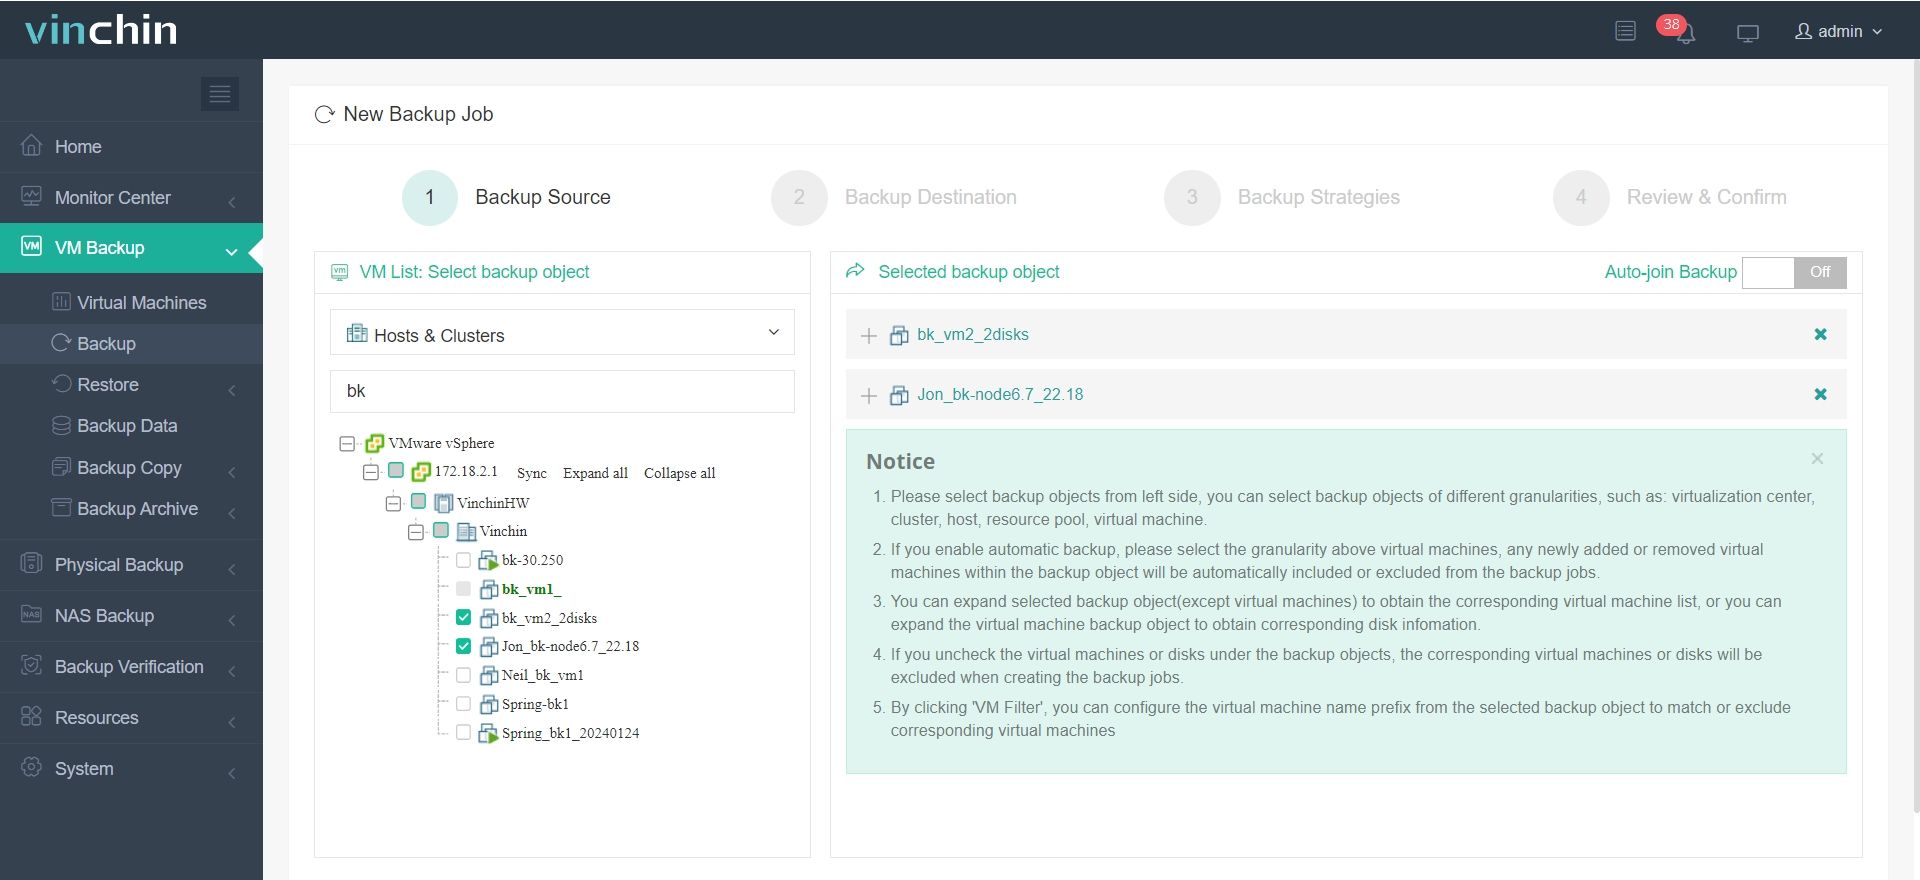
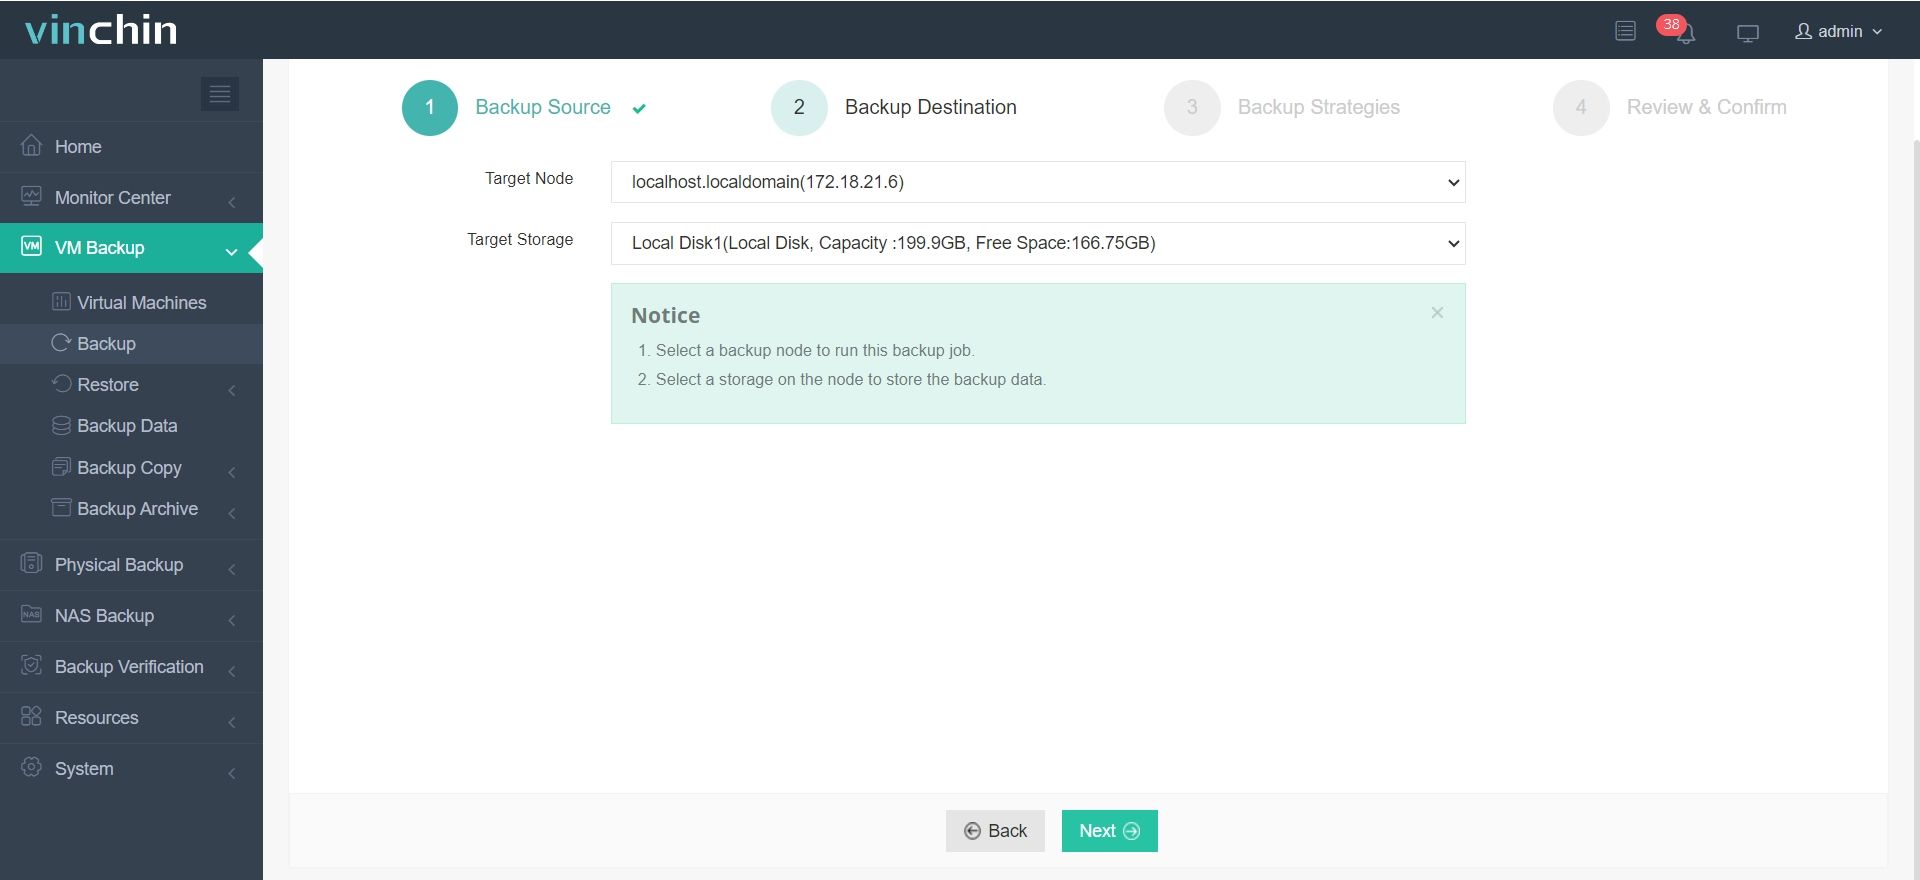
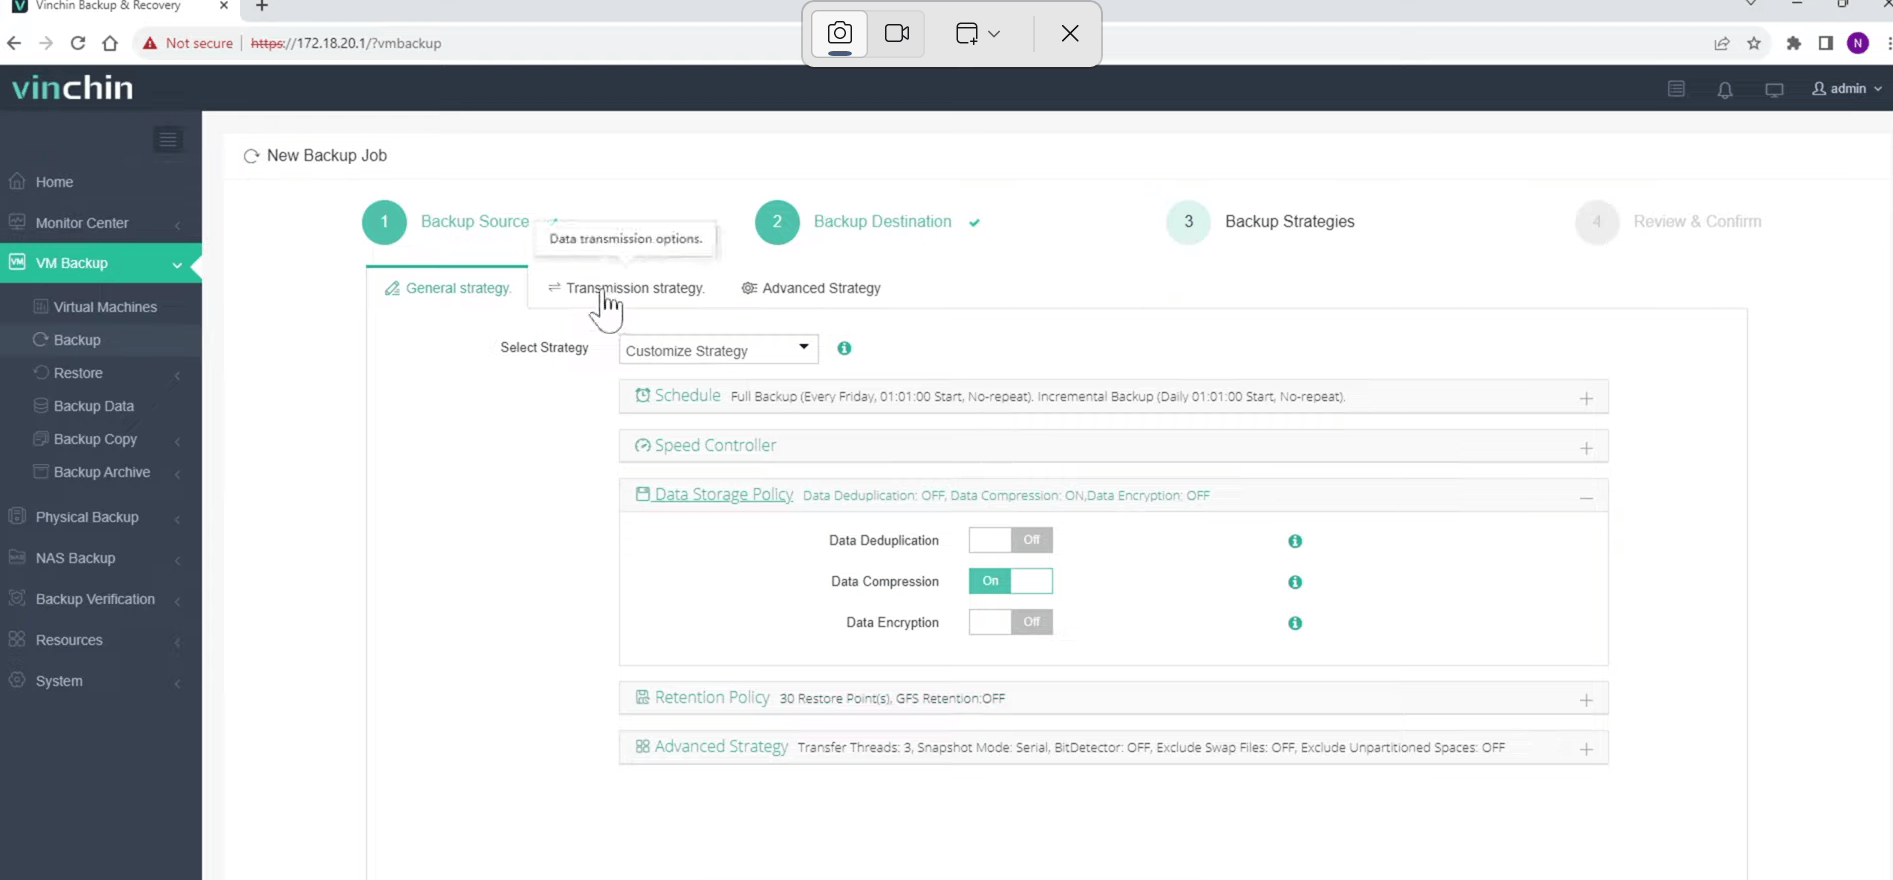
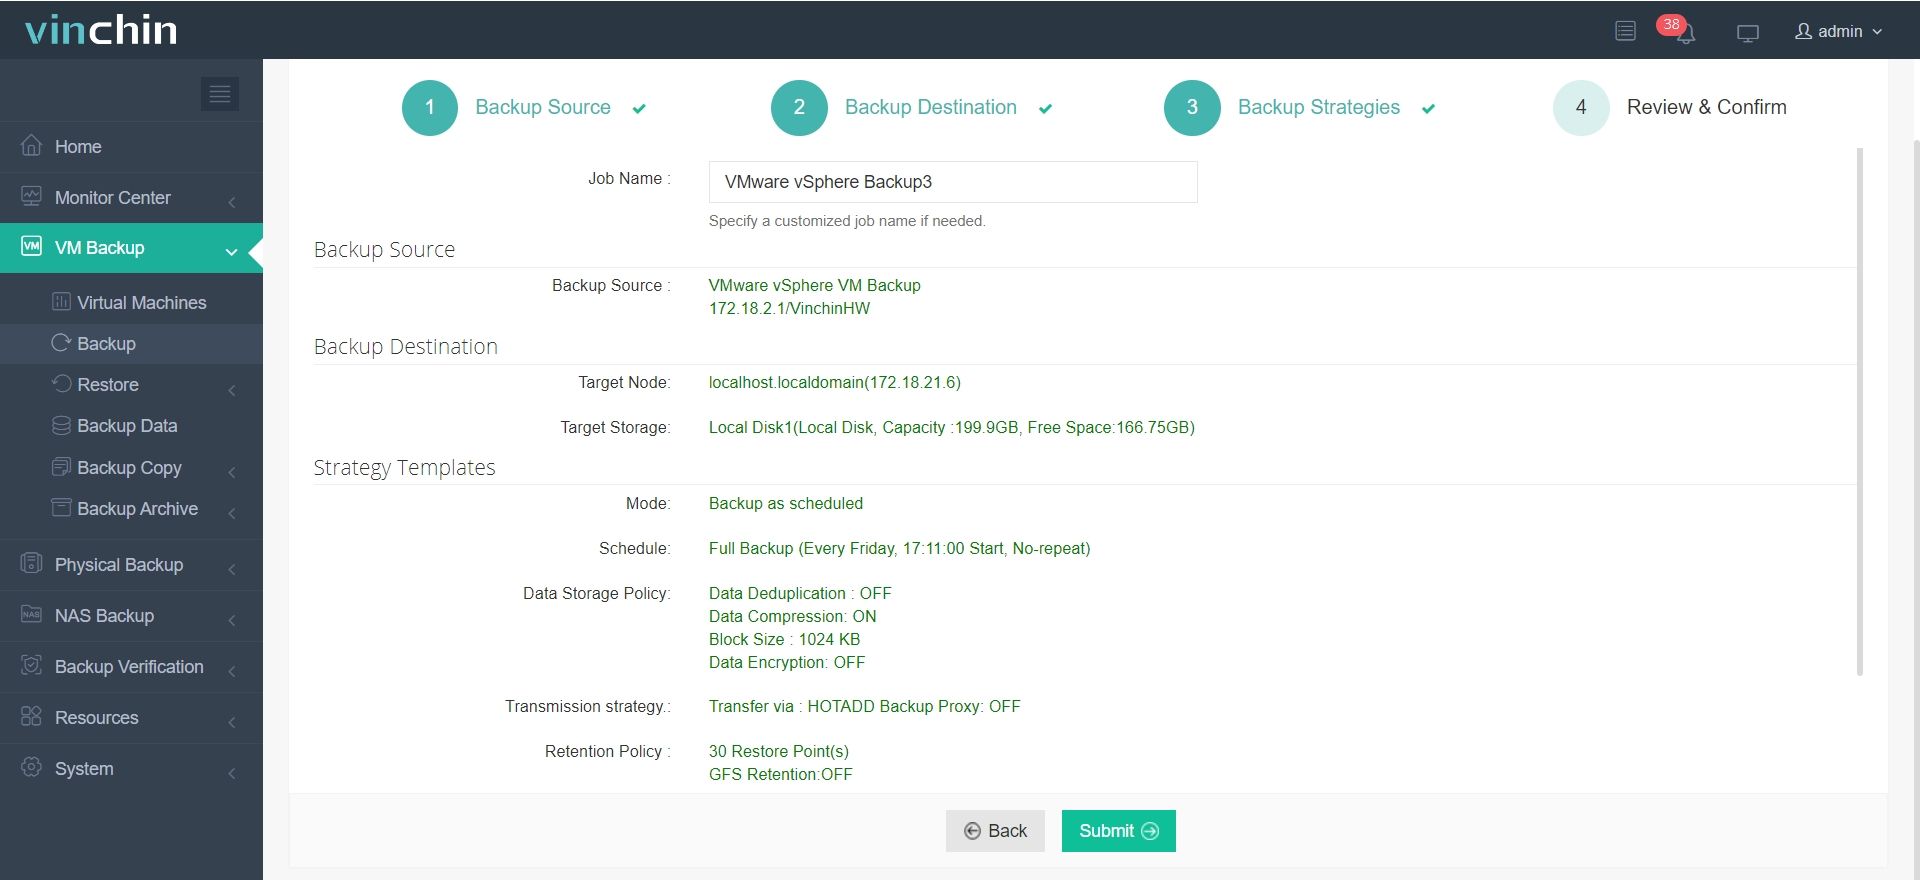
Untuk mengaktifkan deduplikasi selama pencadangan, cukup ikuti langkah-langkah berikut:
1. Pilih mesin virtual yang ingin Anda cadangkan.
2. Pilih tujuan cadangan.
3. Konfigurasikan strategi cadangan.
Dalam bagian "Kebijakan Penyimpanan Data", Anda dapat memilih apakah akan mengaktifkan deduplikasi dan kompresi.
4. Konfirmasi pekerjaan pencadangan.
Selain fitur yang disebutkan di atas, Vinchin juga menawarkan banyak fitur canggih lainnya yang menunggu Anda untuk menjelajahinya. Klik tombol di bawah ini untuk memulai uji coba gratis 60 hari dengan fungsi penuh!
Pertanyaan yang Sering Diajukan tentang Penghapusan Duplikasi Data Cadangan
1. P: Jenis data apa saja yang cocok untuk penghapusan duplikasi dan jenis data apa saja yang tidak cocok?
A: Deduplikasi cocok untuk semua jenis data, termasuk dokumen kantor, basis data, file multimedia, dan mesin virtual. Meskipun beberapa data mungkin tidak menunjukkan efek deduplikasi yang signifikan saat pencadangan pertama karena sifat alami data tersebut, keuntungan deduplikasi akan terlihat jelas pada pencadangan berikutnya. Semakin sering pencadangan dilakukan dan semakin singkat interval waktu antar pencadangan, semakin tinggi rasio deduplikasinya.
2. P: Apa itu deduplikasi blok panjang tetap dan deduplikasi blok panjang variabel?
A: Deduplikasi blok dengan panjang tetap membagi data menjadi blok-blok berukuran sama dan mengidentifikasi duplikasi dengan membandingkan konten setiap blok. Metode ini sederhana tetapi mungkin melewatkan peluang untuk menghilangkan redundansi jika data identik mengalami pergeseran sedikit. Sebaliknya, deduplikasi blok dengan panjang variabel membagi data menjadi blok-blok dengan ukuran bervariasi berdasarkan pola konten, yang memungkinkan deteksi duplikasi lebih tepat meskipun terjadi pergeseran data. Hal ini membuat deduplikasi dengan panjang variabel lebih efisien dalam mengurangi penggunaan penyimpanan, meskipun lebih kompleks dalam implementasinya.
Kesimpulan
Data duplikat tidak hanya membuang-buang ruang penyimpanan, meningkatkan biaya operasional bagi perusahaan, tetapi juga dapat mempengaruhi efisiensi cadangan dan pemulihan data, serta memperumit manajemen data. Oleh karena itu, penggunaan teknologi deduplikasi yang efektif untuk mengurangi data duplikat sangatlah penting. Melalui deduplikasi, perusahaan dapat mengoptimalkan penggunaan ruang penyimpanan, mengurangi biaya, serta meningkatkan efisiensi dan akurasi manajemen data.